Appearance
在提示词前面加了一句“请仔细阅读”,如果效果变好了,我们通常会觉得是这句提醒起了作用,但是实际上可能是因为加了这句提醒,后文的位置整体后移,「位置本身的改动」和「这句提醒本身」一起在起作用
字节 Seed 团队等人的论文 Periodic Weak Spots 研究了这种位置差异,他们让 DeepSeek 补全一段代码,每次只改文件开头的注释长度,发现模型对正确答案的偏好会来回变化,而且大致每四个 Token 重复一次,在另一组基于 DeepSeek-V4-Flash Base 的长文本检索测试中,最好和最差位置组的准确率差值甚至能到 40.2 个百分点
也许这能解释 V4 时不时“抽风”的一部分情况,尤其是任务没变、只调整了前面几句话,回答就跟着变化的时候,除了措辞,后文的位置也值得一起检查
一、从一段没写完的代码说起
论文作者原本写了一个程序要让大模型补全,该程序主要做一次低精度转换,因此需要在空里填 8 才能完成要求,研究人员每次测试都保留这段计算逻辑,通过控制文件开头的注释长短,发现模型给正确答案的概率,大致每隔四个 Token 就经历一轮相似的变化
程序截断的位置如下,模型需要在 FP 后面补上数字,填 8 就是 FP8,填 32 就是 FP32:
text
T.Cast(compute_dtype, T.Cast(FPFP 是 Floating Point,也就是浮点数,数字表示保存一个数要用多少位,FP8 用 8 位,FP32 用 32 位,精度更高,这段程序需要先把数值按 FP8 的精度舍入,再转回 FP32 继续计算,转回去以后用的还是舍入后的数值,因此填 32 就会跳过原本需要的舍入步骤
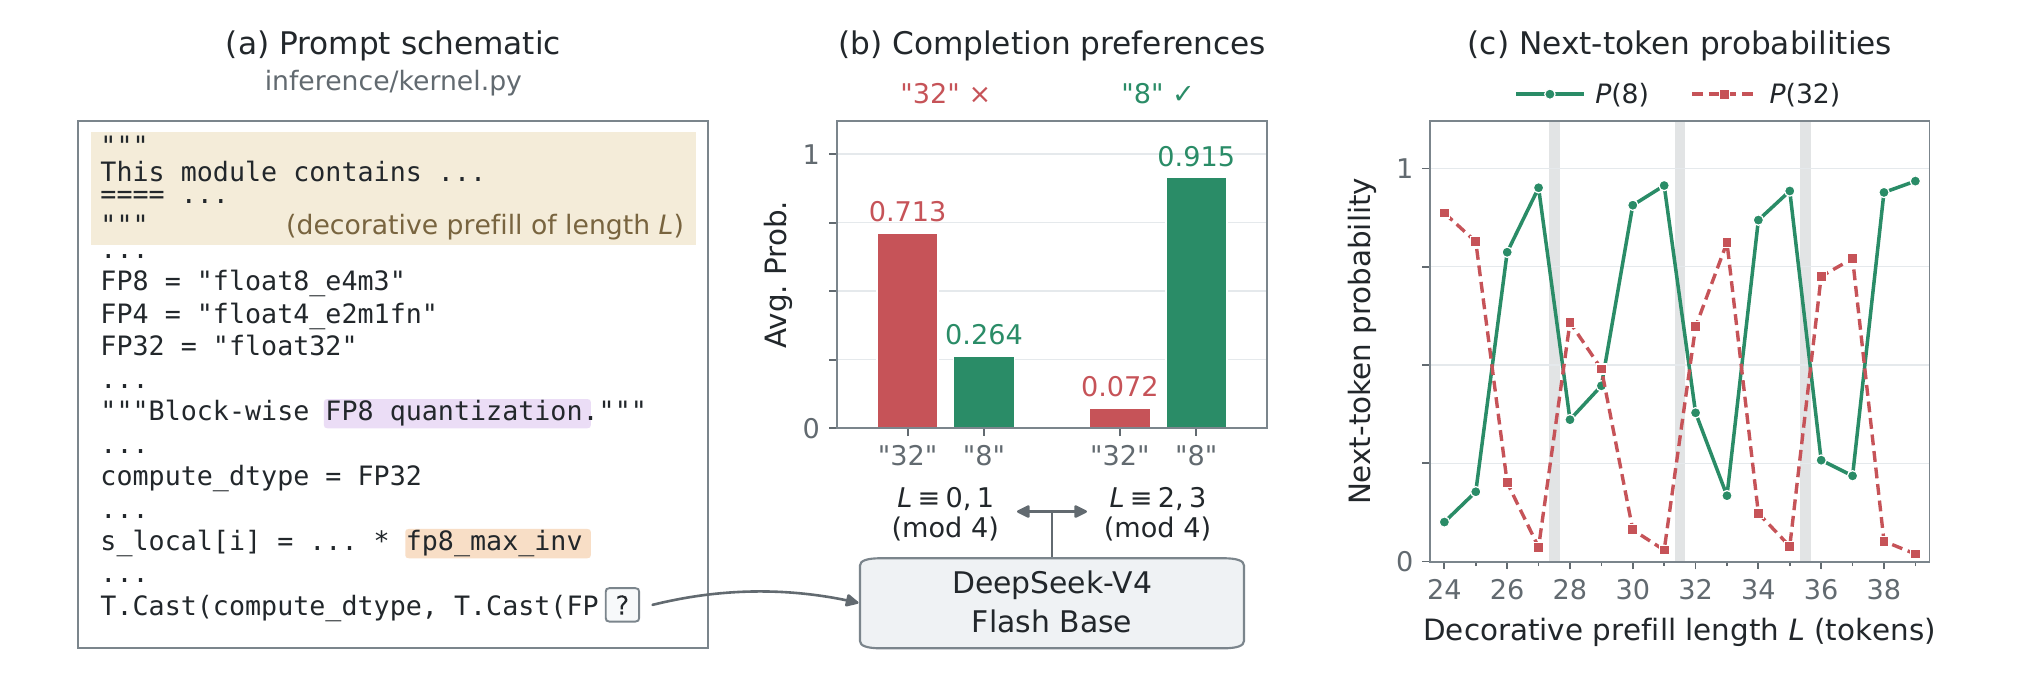
图 1|论文原图,左侧是输入代码,中间是分组统计,右侧绿线表示正确答案 8 的预测概率,红线表示错误答案 32 的预测概率,横轴是注释的 Token 数。
从图里可以看到,注释长度为 24、25 时,模型倾向于填 32,到了 26、27,开始倾向于填 8,继续加到 28、29,又回到了 32,长度按 Token 计算,也就是模型切分文本后使用的片段,和我们平时说的字数并不完全对应
这里测的是模型给两个答案的概率,模型会先算出这些概率,再选择最终输出,因此实验中的起伏在选择答案之前就已经发生了,单靠输入变长或随机生成,很难解释为什么会每隔几个位置重复一次
注释和代码都在模型的输入中,一旦注释变长了,后面的代码整体就会往后挪,这些位置会影响模型对前文的压缩,以及生成后文时对这段信息的读取
大模型生成答案时需要反复用到前面的内容,为了节省重复计算,会把已经算好的键和值保存在显存里,后面生成时接着用,这部分叫作 KV 缓存,K 是 Key,用来匹配要找的信息,V 是 Value,提供对应的内容,存下来的都是模型内部的数值表示
输入越长,需要保存的缓存通常也越多,显存占用就会增加,论文研究的模型会把较早的缓存按相邻位置分组,再把一组里的信息合并成更少的条目,后面读取这部分前文时,用到的就是合并后的结果
前面加了注释,代码在组内的位置可能变化,和它一起合并的内容也可能变化,各部分信息在压缩后保留多少,后面读取时受到多少干扰,都可能受到影响,所以代码的计算逻辑保持不变,模型读取这段代码的效果也可能随着位置变化
作者又训练了一组对照模型,调整压缩操作的间隔,发现检索准确率起伏的周期也跟着改变,不做分块压缩的对照模型没有出现同样明显的周期,这些结果支持了周期与压缩结构之间的联系
论文把这种表现称为相位敏感性,相位在这里可以理解为每轮重复里排第几个位置,比如每四个位置重复一次,就按位置编号除以 4 的余数分成 0、1、2、3 四类,作者还试过让各部分信息在合并时占相同的比例,周期仍然存在,说明除了合并权重,还需要考虑前后的位置处理和读取过程
二、在长文本里,位置差异有多大
论文还做了一组长文本检索实验,给模型约 16,000 条记录,每条记录都有一个标识和对应值,总长度为 128K,约 13 万 Token,模型需要根据指定标识找到对应的值,研究人员保留这些对应关系,只调整目标记录的位置,再分组统计每组答对了多少
各组的输入长度、提问位置都保持一致,目标位置的平均值和分散程度也做了匹配,避免一组总在开头、另一组总在末尾,把离问题远近的影响混进来
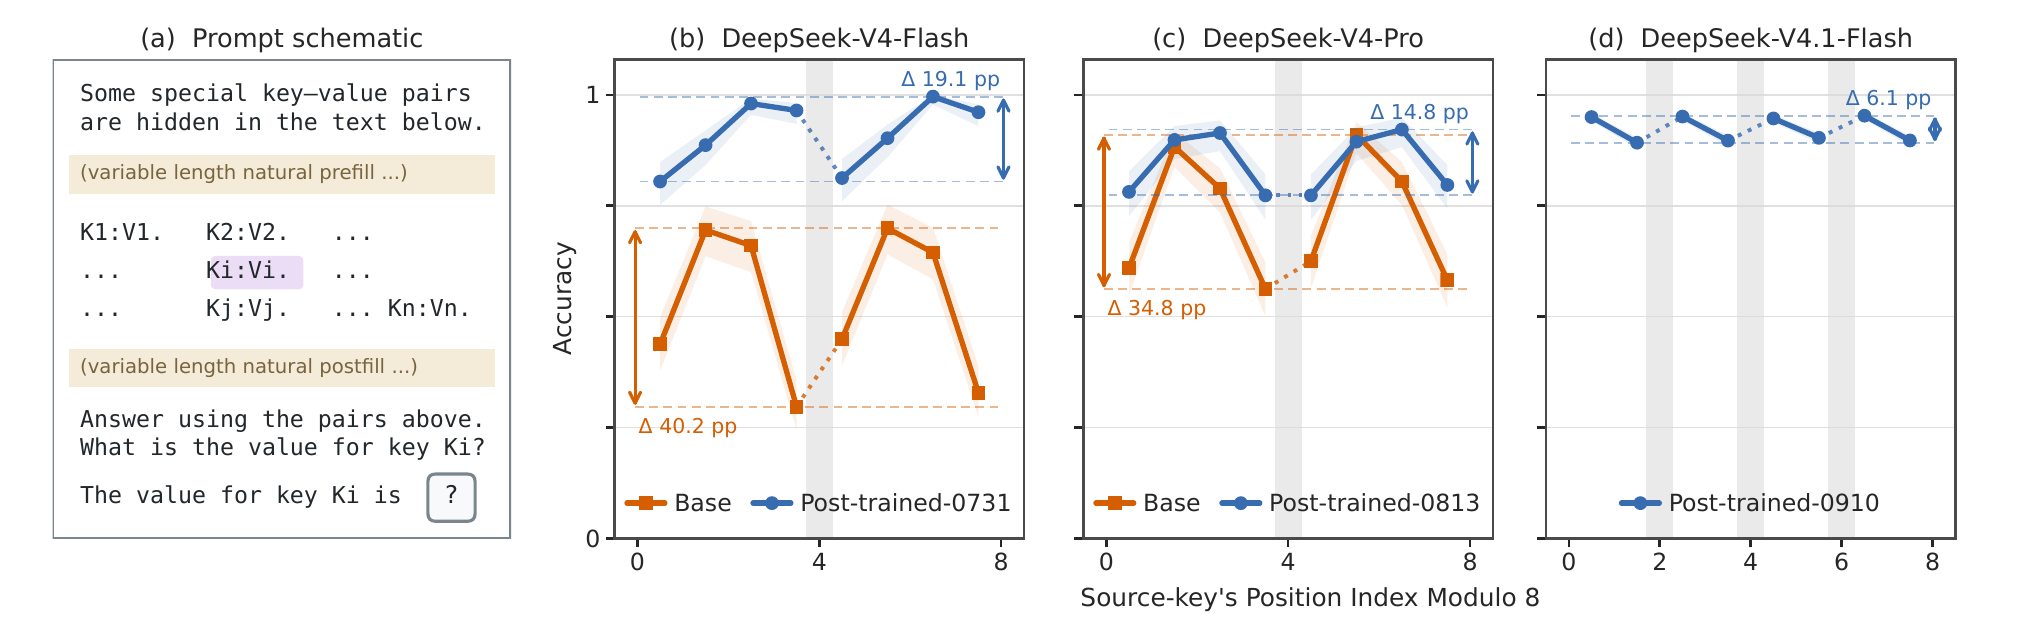
图 2|论文原图,横轴按目标键的位置除以 8 的余数分组,纵轴 Accuracy 是准确率,Δ 表示最好与最差位置组的差距,阴影表示统计不确定性。
图中的 Base 是经过大规模文本预训练的基础模型,Post-Trained 是继续用指令、偏好等数据训练过的版本,更适合按要求完成任务,0731、0813、0910 是论文测试的版本标记
Flash 基础版最好和最差的位置组相差 40.2 个百分点,Pro 基础版相差 34.8 个百分点,这里的百分点就是两个百分比直接相减,比如 80% 和 60% 相差 20 个百分点,经过后续训练,Flash 的 0731 版把差距缩小到了 19.1 个百分点,Pro 缩小到 14.8,V4.1-Flash-0910 为 6.1
经过后续训练,模型整体上答得更准了,不同位置之间的差距也小了,不过图里的曲线仍然有规律地起伏,说明答案放在哪里,还是会影响模型能不能找对,只看平均准确率,很难知道模型在哪些位置容易出错
我们在业务里通常会复用一套 Prompt 模板,关键内容也往往放在固定的地方,如果这些位置刚好容易出错,就可能出现评测分数不错、实际使用时经常出问题的情况,所以测试时可以直接用业务里的模板,再把关键内容换几个位置试一试,看看回答是否仍然稳定
三、改提示词时怎么用到这些结果
平时改 Prompt,我们更多会关注要求有没有说清楚、例子给得合不合适,这篇论文让我们多认识到一点:除了 Prompt 的内容,文字在输入中的位置也可能影响模型输出,即使任务要求和关键内容都没变,只是在前面多加了一段说明,后面的文字换了位置,模型读取它们的效果就可能跟着变化
在前面“请仔细阅读”的例子里,如果我们加了一句话,发现效果变好了,就可以继续用同一批问题和材料,把材料换几个位置,分别比较加这句话和不加这句话的结果,每次使用同一个模型版本和同一套生成参数
如果改善集中在原来那套排列里,这次修改就比较依赖当前模板,如果换过位置以后依然有改善,我们对这个改法适用于其他排列也会更有把握,这样测可以了解改法对位置有多敏感,要分清措辞和位置各自起了多少作用,还需要更严格的对照
因为前面增加文字时,包含答案的记录和其他干扰记录会一起往后移,两部分都可能影响结果,论文又通过改变记录之间的间隔,分开调整它们的位置,实验中仍然观察到了周期,进一步支持了目标位置本身会影响结果的判断
这些结果来自论文测试的条件,其他任务中的最佳位置还需要另行验证,模型回答不稳定也可能有其他原因,平时做评测可以先把业务实际使用的输入格式放进去,把每次完整的输入和结果一起保存,以后加了系统说明、改了提示词前缀或者换了材料模板,就用原来的测试集再测一次,看看之前的改善还能不能保持
参考文献与图片来源
Xingyu Zhu 等,Periodic Weak Spots: Phase Sensitivity from Chunked KV-Cache Compression,arXiv:2609.36322,2026 年 9 月,长文本检索与版本对比见第 2 节,平均准确率与最差位置对比见第 3.2 节。