Appearance
递归自我改进(Recursive Self-Improvement,RSI)的概念可以追溯到 I. J. Good(1965)。他将“超智能机器”定义为一种在所有智力活动上都能超越人类,并能通过设计更好的机器来改进自身的系统。Yudkowsky(2008) 用“递归自我改进”描述一种特定的反馈循环:AI 运用现有智能,改进产生这种智能的认知机制。
在今天的 AI 系统中,这种反馈循环可以指模型直接改写自己的权重,也可以指更广义的过程:模型改进训练流程和部署系统,进而产生更好的后继模型,让它在具有经济价值的任务上表现得更好。前沿实验室已经展示了 AI 研究速度的大幅提升(Anthropic;OpenAI)。
部署系统连接着原始模型与现实环境,这一层似乎与模型本身的智能同样重要,这里的模型智能指的是预训练刚结束时测得的能力。Claude Code、Codex 等编程 Agent 产品的成功,说明 Harness 是 AI 部署中的重要组成部分。Harness 是围绕基础模型构建的系统,负责组织执行过程,决定模型如何思考和规划、调用工具并采取行动、感知和管理上下文、保存产物,以及评估结果。
Harness 工程如何推动 RSI,可以作为理解近期自动研究、自我改进 Agent 和演化式程序搜索等工作的一条线索。模型自博弈、合成数据、测试时训练,以及更广义的持续学习,也符合 RSI 的愿景,例如 Yuan 等(2024)、Chen 等(2024)、Zhao 等(2025) 和 Choi 等(2026) 的研究,这些方向不在这里展开。
Harness 的设计模式
早期 Agent 框架通常将 Agent 看作大语言模型、记忆、工具、规划和行动的组合。Harness 工程在此基础上,还包括工作流设计,例如循环机制,以及评估、权限控制和持久状态管理。它已经超出了提示词模板的范围,更接近运行时和软件系统设计,关心模型如何观察、行动、记忆、自查和改进。
为了支持泛化,设计应当有意保持简单、通用,并尽量借鉴已有的软件工程实践,以利用模型在预训练中学到的知识。Harness 与操作系统也有很强的相似性:它需要封装复杂逻辑,同时保持接口简单。配置、工具接口及其他协议,也可能逐渐形成行业标准。
模式一:工作流自动化
为模型定义一套能够操作、测试和迭代的工作流,是实现自动化的关键。Karpathy 的 autoresearch 仓库提供了一个简洁的例子。常见的工作流围绕目标循环推进:规划、执行、观察或测试、改进,再次执行,直到达成目标。过程中,系统也可能主动询问用户,以澄清任务要求或执行偏好。
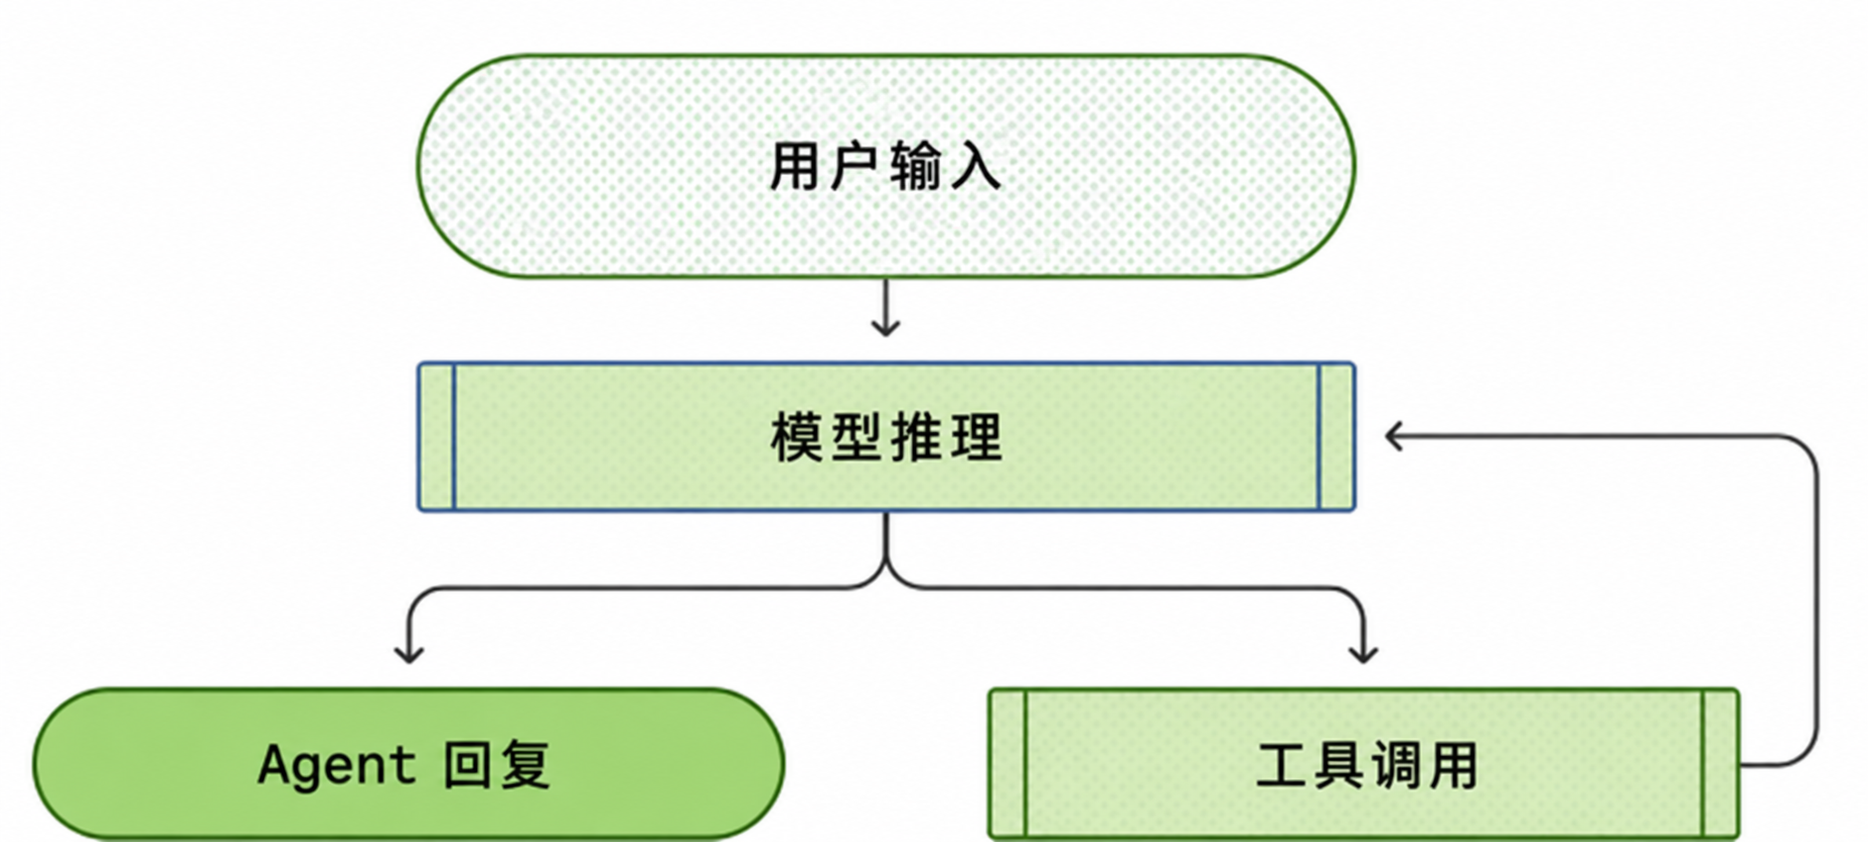
简化的 Codex Agent 循环:Agent 调用工具,工具返回的结果影响模型下一次生成。图片来源:OpenAI 的 Codex Agent 文章。
工作流还强调,模型需要分析自己的执行轨迹和失败案例,通过 Agent 运行时不断推进任务,而不只是依赖一份静态提示词模板。
模式二:用文件系统保存持久记忆
长程 Agent 系统中反复出现的一种设计,是用简单的控制方式管理丰富的状态和产物。Harness 不应把整个工作流和所有日志都装进上下文,而应将需要长期保留的状态写入文件。Agent 长时间运行后,实验日志、代码差异、论文摘要、错误轨迹和过去的执行记录,往往会远远超过模型训练时所适应的上下文窗口。
学会读写和编辑文件系统,通常通过 bash 命令完成,是大语言模型的一项基础技能。因此,用文件这种简单形式管理持久记忆,可以自然受益于模型基础能力的提升。
模式三:子 Agent 与后台任务
Harness 可以创建多个子 Agent 并行执行,也可以监控后台任务。当主 Agent 需要探索多个假设、并行运行实验,或者将独立子任务交出去、避免干扰主上下文时,这种设计很有用。父 Agent 随后需要一个小型进程管理器,负责启动任务、查看日志、取消失败的运行,并将结果合并回主 Agent 的执行线程。
设计时,需要让并行过程清晰可见、可以检查。如果子 Agent 的输出只存在于临时对话上下文中,很快就会过时,也不容易再找到;如果将它们保存为文件、日志和状态记录,模型就能在中断后恢复,并根据自己的执行历史继续判断。
案例:编程 Agent 的 Harness
Claude Code、Codex、OpenCode 和 Cursor 这类主流编程 Agent 的核心接口,已经逐渐趋于一致。它们通常采用下面这样的循环:
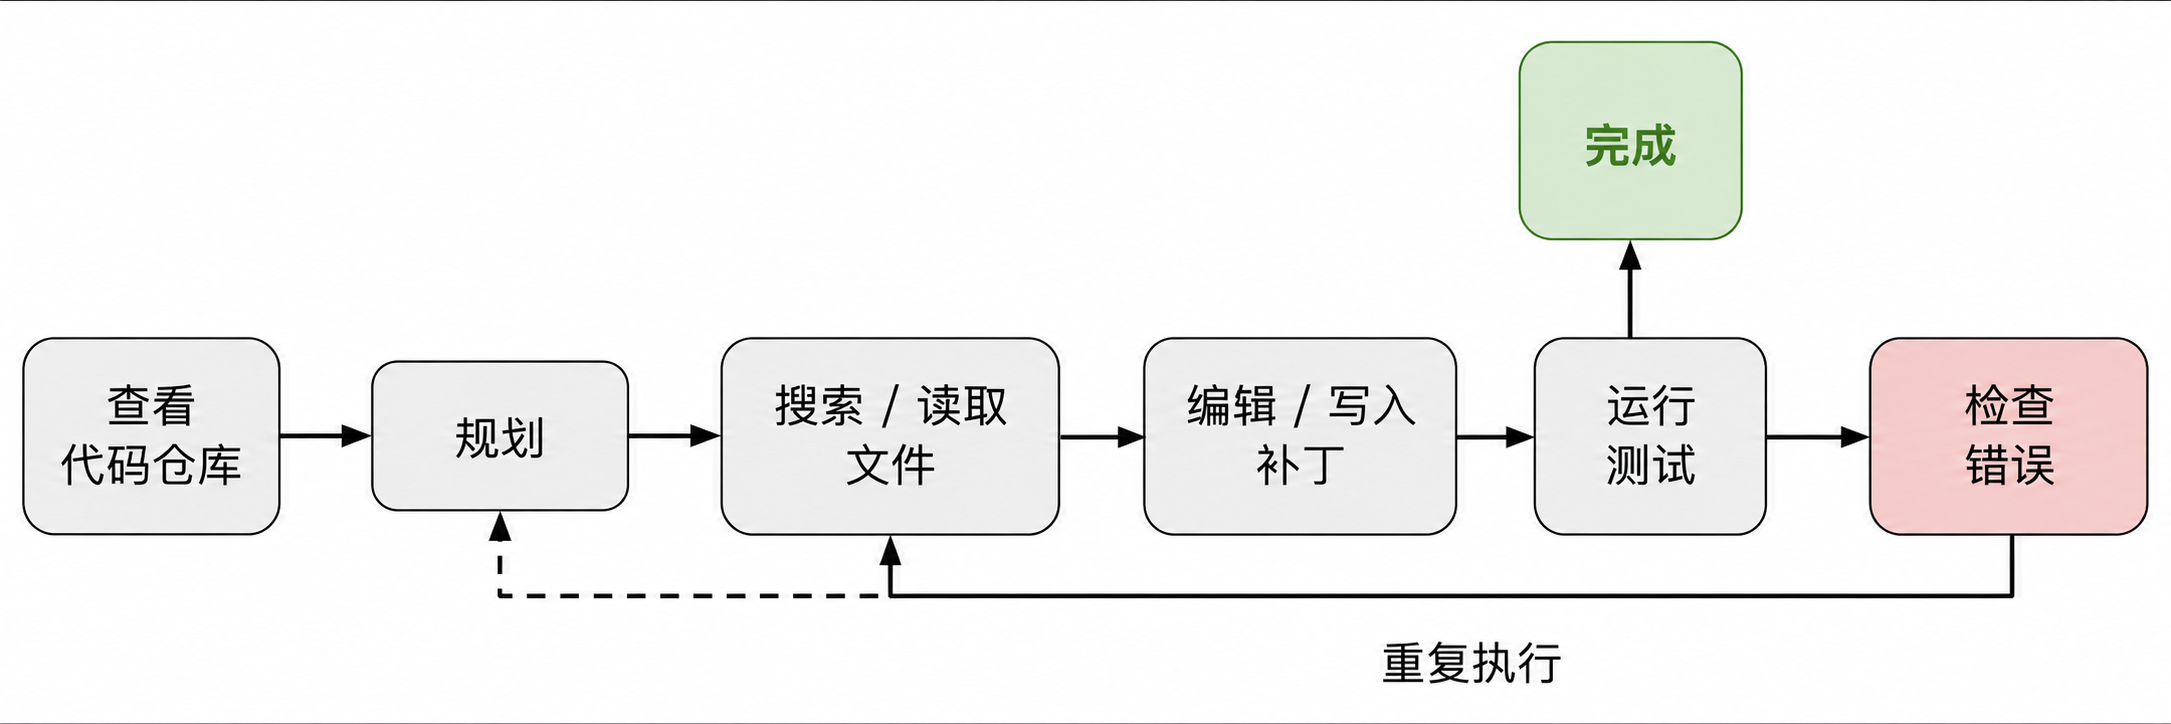
有了这些工具,编程 Agent 就能在指定仓库中开发和排查问题,就像人类开发者借助 IDE 工作一样。
下表仅用于举例,并非完整清单。感兴趣的话,可以阅读这份资料。
| 类别 | 工具定义 |
|---|---|
| 文件系统 | 查找文件:glob、grep、ls;读取文件:read、read_many;修改文件:write(写入完整的新文件)、edit(精确匹配字符串后替换)、multi_edit、apply_patch(应用结构化补丁或差异) |
| Shell 执行 | 运行命令:bash、PowerShell |
| 输入输出 | lsp,以及 git_status、git_diff、git_commit 等 Git 工具 |
| 外部上下文 | MCP 工具、Skills |
| 网页搜索 | web_search、web_fetch、浏览器工具 |
| 产物 | 读取文档和图片,生成 HTML 和图片 |
| 后台进程 | 例如 CronCreate、CronDelete、CronList |
| Agent 委派 | 例如 spawn_agent、resume_agent、wait_agent、list_agents、close_agent、interrupt_agent |
Harness 层与模型核心智能
很难预测未来的 RSI 会在多大程度上依赖 Harness 工程,但近期的路径大概不会从模型直接改写自身权重开始。一种可能的近期路径是:
- Harness 工程向元方法论发展,改进产生更好答案的机制,而不仅是答案本身。Harness 系统会成为优化对象,逐渐减少启发式规则,采用更通用的机制。
- 成熟的 Harness 支持自动研究,推动模型自我改进;更聪明的模型则能避免 Harness 过度设计,使整个系统可以持续发展。
最终,许多 Harness 层面的改进可能会被模型内化为自身行为,但与外部上下文和工具交互的接口仍会存在。提示词工程已经出现过一个较温和的版本:随着指令微调和推理能力进步,手工设计提示词技巧变得没那么重要,但指定目标、约束、上下文和评估方式的需求并没有消失。
Harness 优化
Harness 系统中的优化对象,大致沿着这条路径发展:指令提示词、结构化上下文、工作流、Harness 代码,再到优化器代码。随着模型能力增强,优化对象逐渐变得更复杂,所用的方法也更通用。
上下文工程
随着 Agent 的任务跨度显著增加,如果只是不断把工具响应和模型输出追加到上下文里,长度很快就会失控。上下文管理负责为大语言模型组织更有结构、更精简的上下文,同时管理持久状态。长上下文研究无疑还会继续进步,但在现阶段,模型的长上下文能力与上下文工程有时仍然交织在一起。
Agentic Context Engineering(ACE;Zhang 等,2025)将上下文视为一份不断演进的工作手册,而不是一条越写越长的提示词。它用三个组件维护这份手册,手册中的每个条目都有标识和说明:
- 生成器(Generator)参考这些条目,生成任务执行轨迹。
- 反思器(Reflector)从成功和失败的轨迹中提炼经验。
- 整理器(Curator)通过增量条目更新结构化上下文。
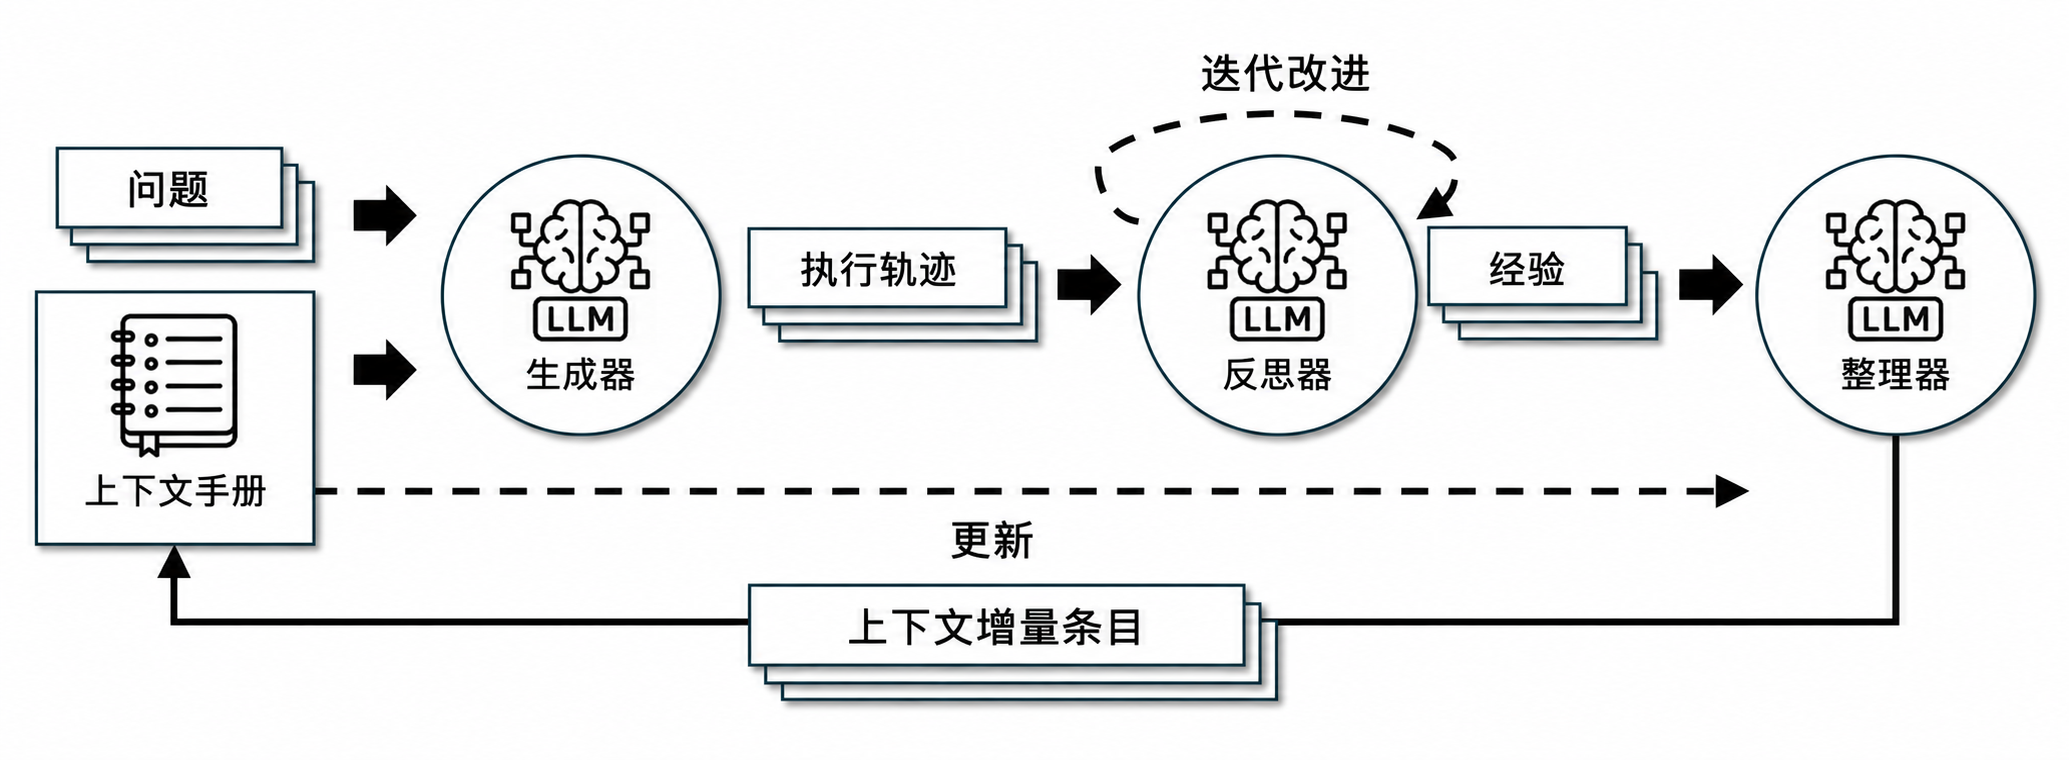
Agentic Context Engineering(ACE)框架。图片来源:Zhang 等,2025。
为了避免反复改写造成上下文坍缩,以及偏向简短表达而丢失信息,ACE 的一个重要设计是:整理器不重写整块提示词,而是输出带有标识和说明的结构化条目,再通过确定性逻辑将这些条目合并到上下文记录中,并定期细化、去重。
ACE 从执行轨迹中学习经验,朝着自主管理记忆迈进了一步,但更新规则和整体工作流仍由人手工设计。Meta Context Engineering(MCE;Ye 等,2026)进一步将机制,也就是如何管理上下文,与产物内容,也就是上下文里有什么,分开处理:在元优化层演化 Skill,在基础层优化上下文。
MCE 的 Skill 定义了根据输入构造上下文的方法,其中既有提示词、知识库、代码库等静态组成,也有搜索、选择、过滤和格式化等动态操作。
双层优化的内层,在给定 Skill 的条件下,利用训练数据寻找最佳上下文;外层则寻找能在验证集上取得最佳表现的 Skill。
Skill 数据库记录此前的 Skill、上下文函数和评估指标。元层 Agent 根据当前任务,对已有 Skill 进行交叉组合,产生新的 Skill。随后,基础层的上下文工程 Agent 执行该 Skill,在它的指导下,根据执行反馈学习上下文函数。
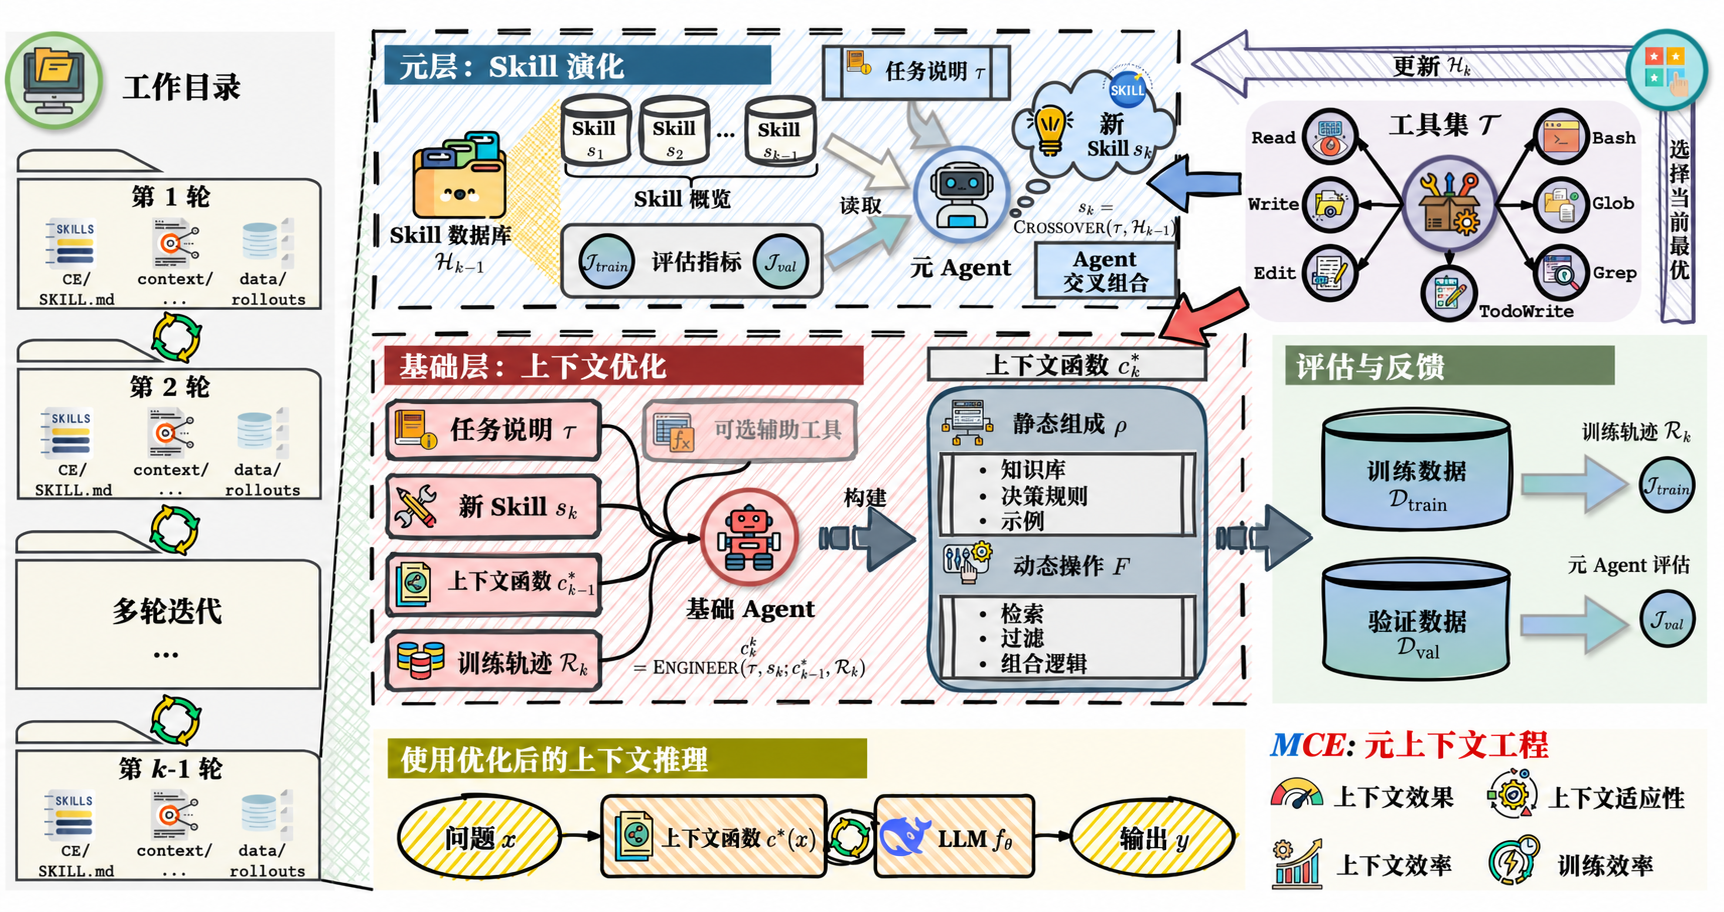
Meta Context Engineering(MCE)框架:元层的 Skill 演化搜索上下文管理机制,基础层则优化任务上下文。图片来源:Ye 等,2026。
MCE 不像 ACE 那样,以启发式规则规定上下文必须如何组织。它用自由形式的 Skill 保存任务中最重要的知识,并让 Skill 及其指导下生成的上下文共同迭代。在实现上,上下文函数是一组存放于专用目录的文件,既包括 skill.md 这样的静态部分,也包括上下文和数据执行轨迹等动态部分。元层和基础层的优化,都在配备标准工具的 Agent 编程环境中进行,工具包括 Read、Write、Edit、Bash、Glob、Grep 和 TodoWrite。
Meta-Harness(Lee 等,2026)又深入了一层:它优化的是代码,这些代码决定如何保存、检索信息,以及向模型呈现什么信息。名称中的“Meta”表示,它是一套用来优化 Harness 的 Harness。
负责提出新 Harness 的系统本身就是一个编程 Agent,最终输出的是一组位于帕累托前沿的 Harness 候选方案。
- 完整执行历史可以通过文件系统访问,编程 Agent 用
grep、cat等命令查阅,而不必把所有内容塞进同一份提示词上下文。 - 每个提出的 Harness 都在文件系统中有自己的目录,保存源代码、得分、执行轨迹和状态更新。
- Meta-Harness 循环不断创建新的 Harness,只保留符合条件的版本。
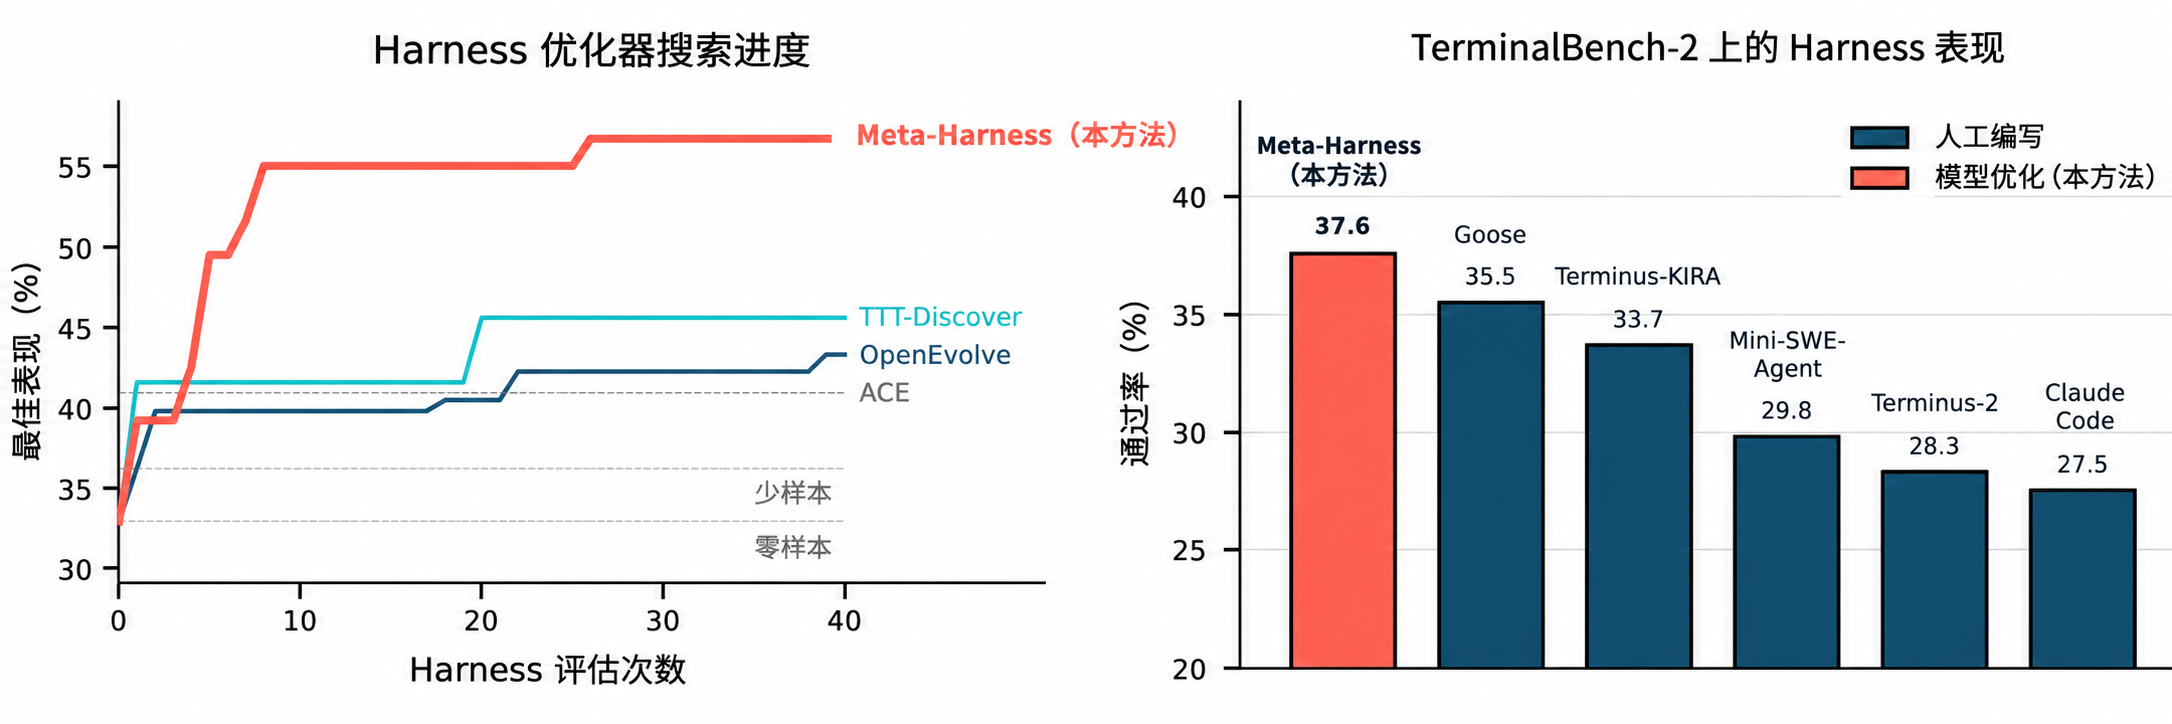
Meta-Harness 的表现:左图是少量迭代下的文本分类结果,右图是 TerminalBench-2。TerminalBench-2 实验中的搜索,从 Terminus-KIRA 和 Terminus-2 这两个很强的 Harness 开始。图片来源:Lee 等,2026。
一旦 Harness 设计成为可以运行和搜索的空间,能力较强的编程 Agent 就能探索人类工程师使用的同一片设计空间。
工作流设计
Harness 中的工作流可以由领域专家手工设计。以自动研究为例,研究者已经提出并测试了多种框架。AI Scientist 系统(Lu 等,2026)建立了一条完整流程,包括提出研究想法、编写代码、运行实验、分析结果、撰写论文,以及同行评审。Meng 等(2026)则在 ScientistOne 中将可验证性作为核心设计约束,要求每项主张,无论涉及引用、数值、方法还是结论,都能追溯到证据来源,并通过证据链检查进行审计。
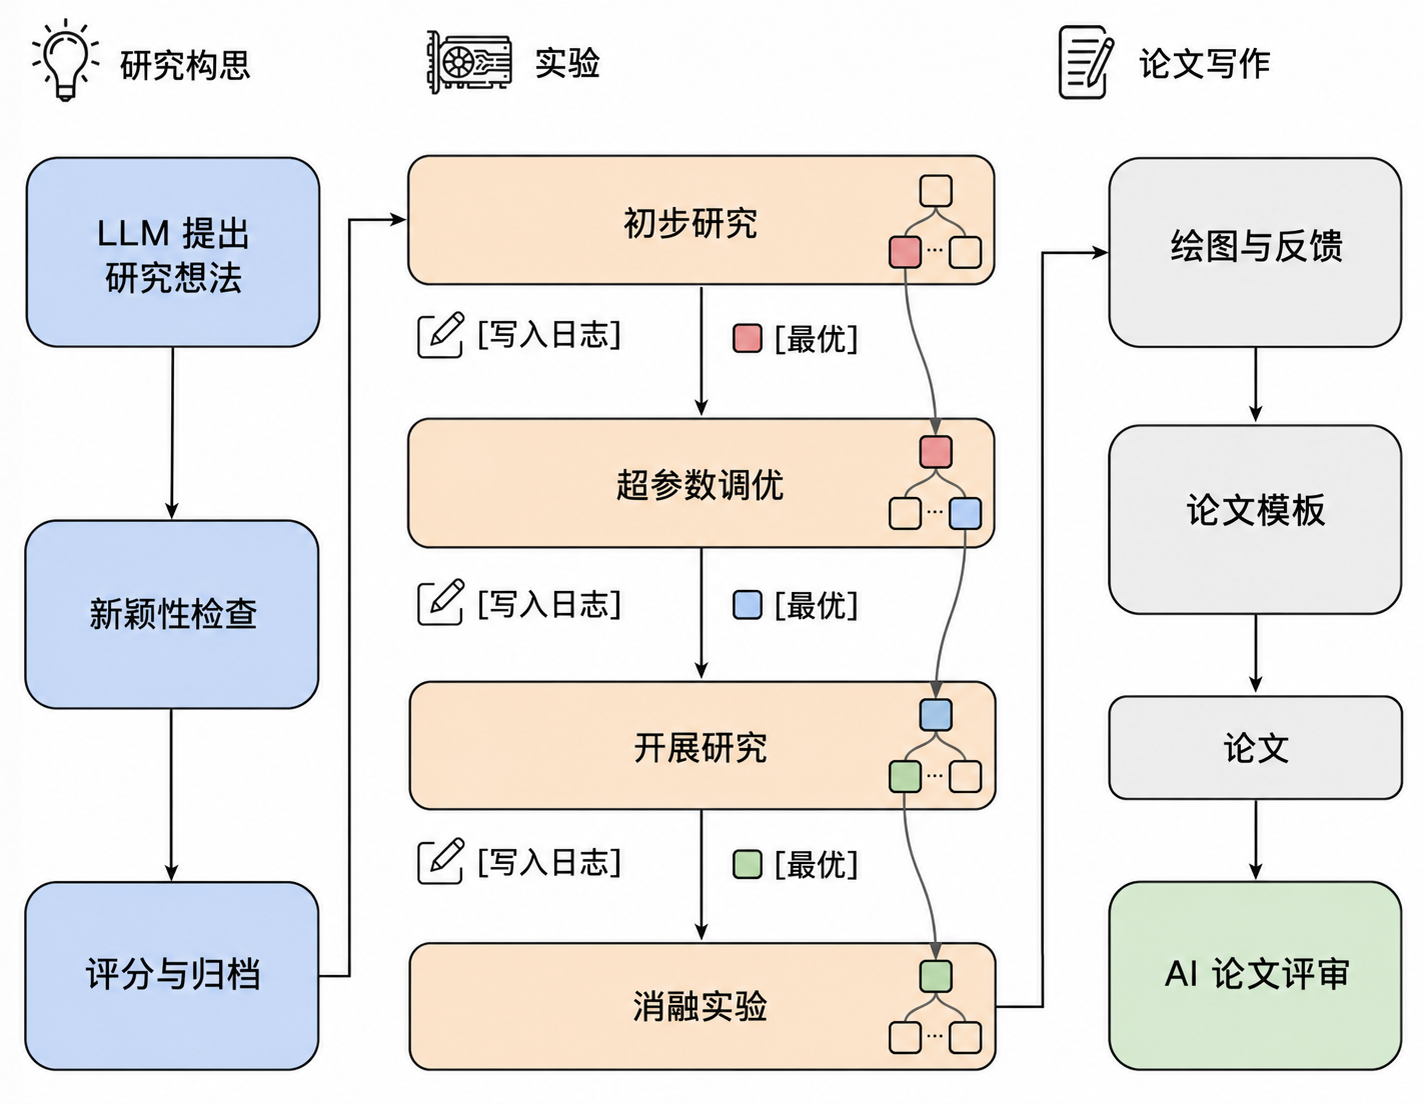
AI Scientist 的流程,包括想法生成、实验、论文写作和评审。图片来源:Lu 等,2026。
Autodata Agent(Kulikov 等,2026)被设计成一名数据科学家,负责生成训练和评估数据。主 Agent 管理着提出问题的挑战者、较弱的解题模型、较强的解题模型,以及验证器或评判器,目标是合成难度“恰到好处”的数据:强模型能解决,弱模型解决不了。
Autodata 根据解题模型和验证器的反馈,不断更新挑战者的提示词。它的局限在于,合成任务用于微调弱模型,而没有用于改进强模型。如果这个循环不能持续改进强模型,那么它更像是在生成的提示词分布上做间接蒸馏,与 RSI 的关系也就弱一些。
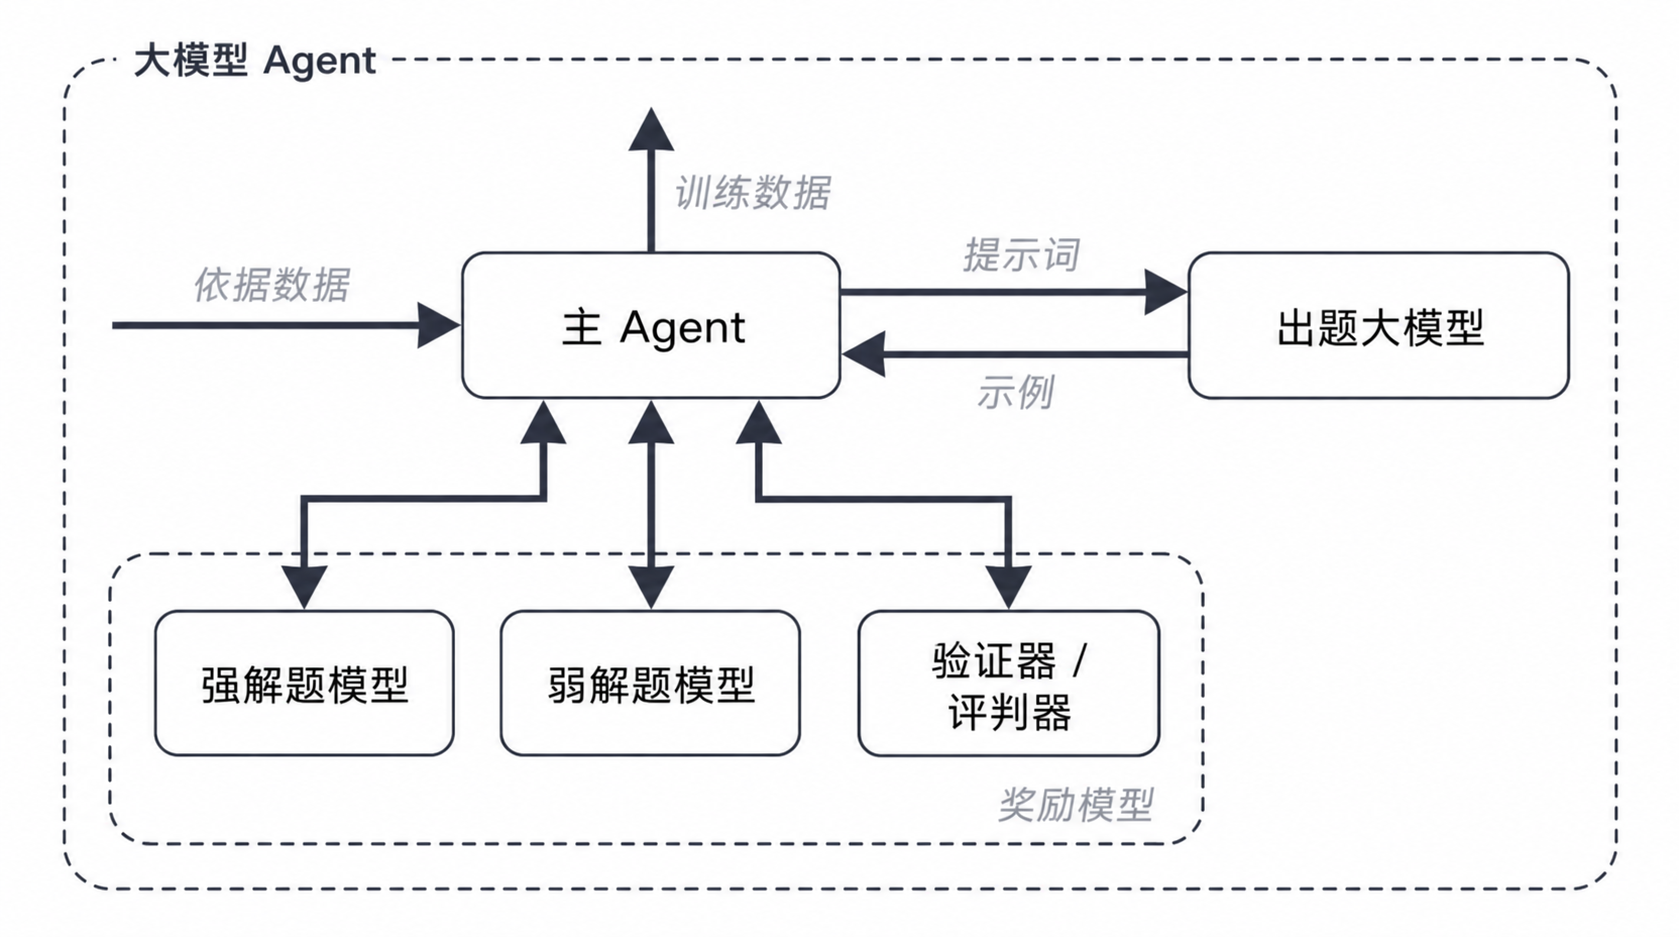
Autodata 围绕挑战者、解题模型和验证器组织工作流,生成合成训练与评估数据。图片来源:Kulikov 等,2026。
工作流的设计空间非常大,很自然可以将它看成一个搜索问题,用算法寻找好的方案,而不只依赖人工设计。沿着这个方向,Automated Design of Agentic Systems(ADAS;Hu 等,2025)把 Agent 设计本身变成了优化问题,称为“元 Agent 搜索”:由一个元 Agent 提出新的 Agent 工作流。
- 用 CoT、自我修订等简单 Agent 初始化工作流档案库。
- 让元 Agent 参考档案库中的已有方案,用代码编写新的 Agent。它先生成工作流的高层描述,再实现为代码,随后对初稿进行两轮自我修订,检查其新颖性。这里的自我修订,是先让模型给出反馈,再由同一个模型根据反馈修改此前的输出(Madaan 等,2023)。
- 评估每个新候选,将成功的方案加入档案库。
- 重复第二、三步,直到达到最大迭代次数。
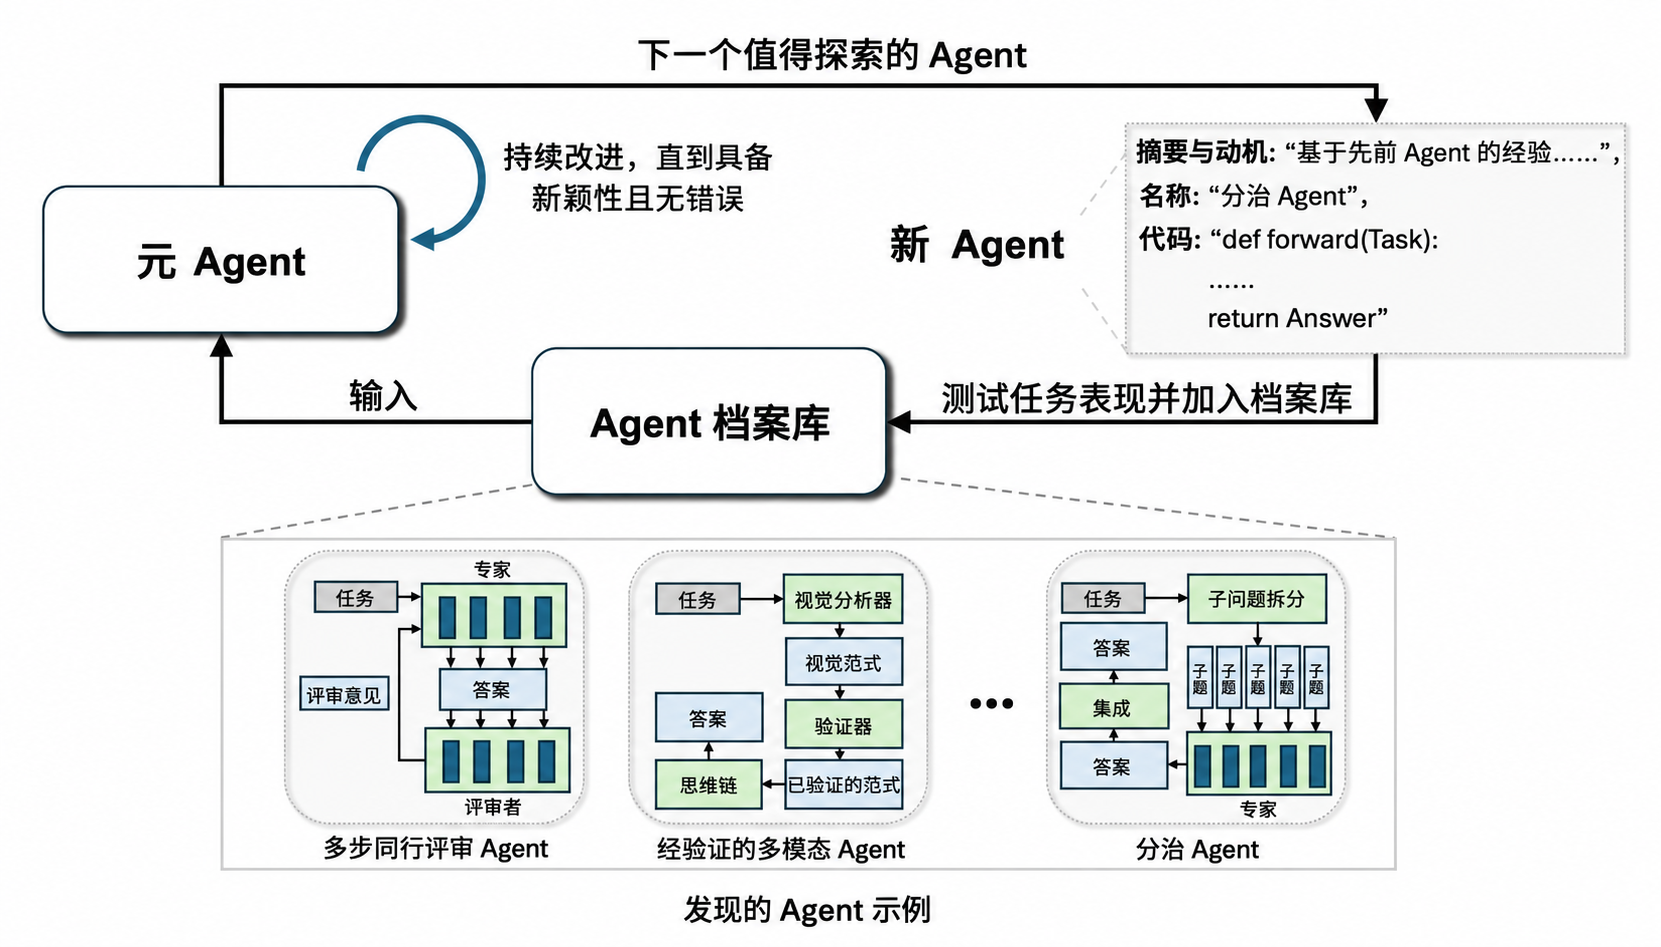
Automated Design of Agentic Systems(ADAS)示意图。图片来源:Hu 等,2025。
AFlow(Zhang 等,2025)将 Agent 工作流表示为图,节点代表调用大语言模型的动作,边通过代码实现逻辑操作。它利用蒙特卡洛树搜索(MCTS)优化工作流:
- 用模板初始化搜索树中的起始工作流。
- 综合得分和均匀探索,选择一个工作流节点。
- 根据该工作流的评估表现,让大语言模型生成修改后的工作流,扩展节点。
- 执行并评估新工作流。
- 如果新工作流在给定的轮次预算内取得改进,就将它加入搜索树。
- 重复第二至第五步,直到得分最高的一组候选的平均分不再提升,或者用完预算。
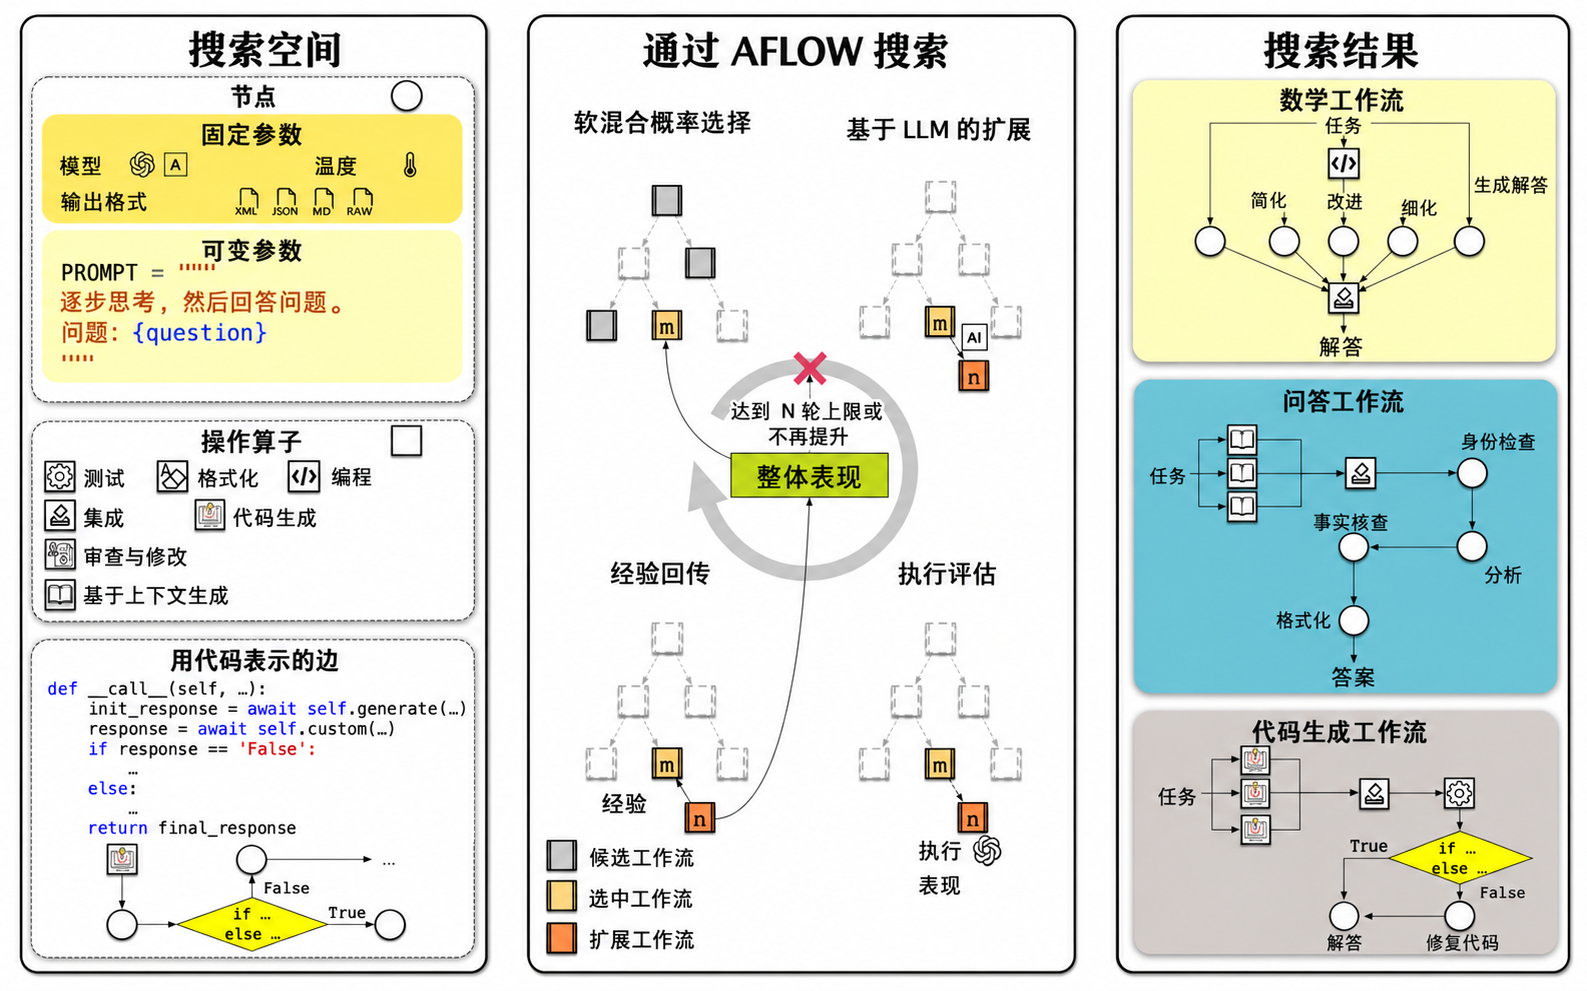
AFlow 在候选工作流组成的树上进行优化。图片来源:Zhang 等,2025。
在问答、代码和数学任务上,AFlow 相比人工设计的工作流和 ADAS,都取得了不错的提升。
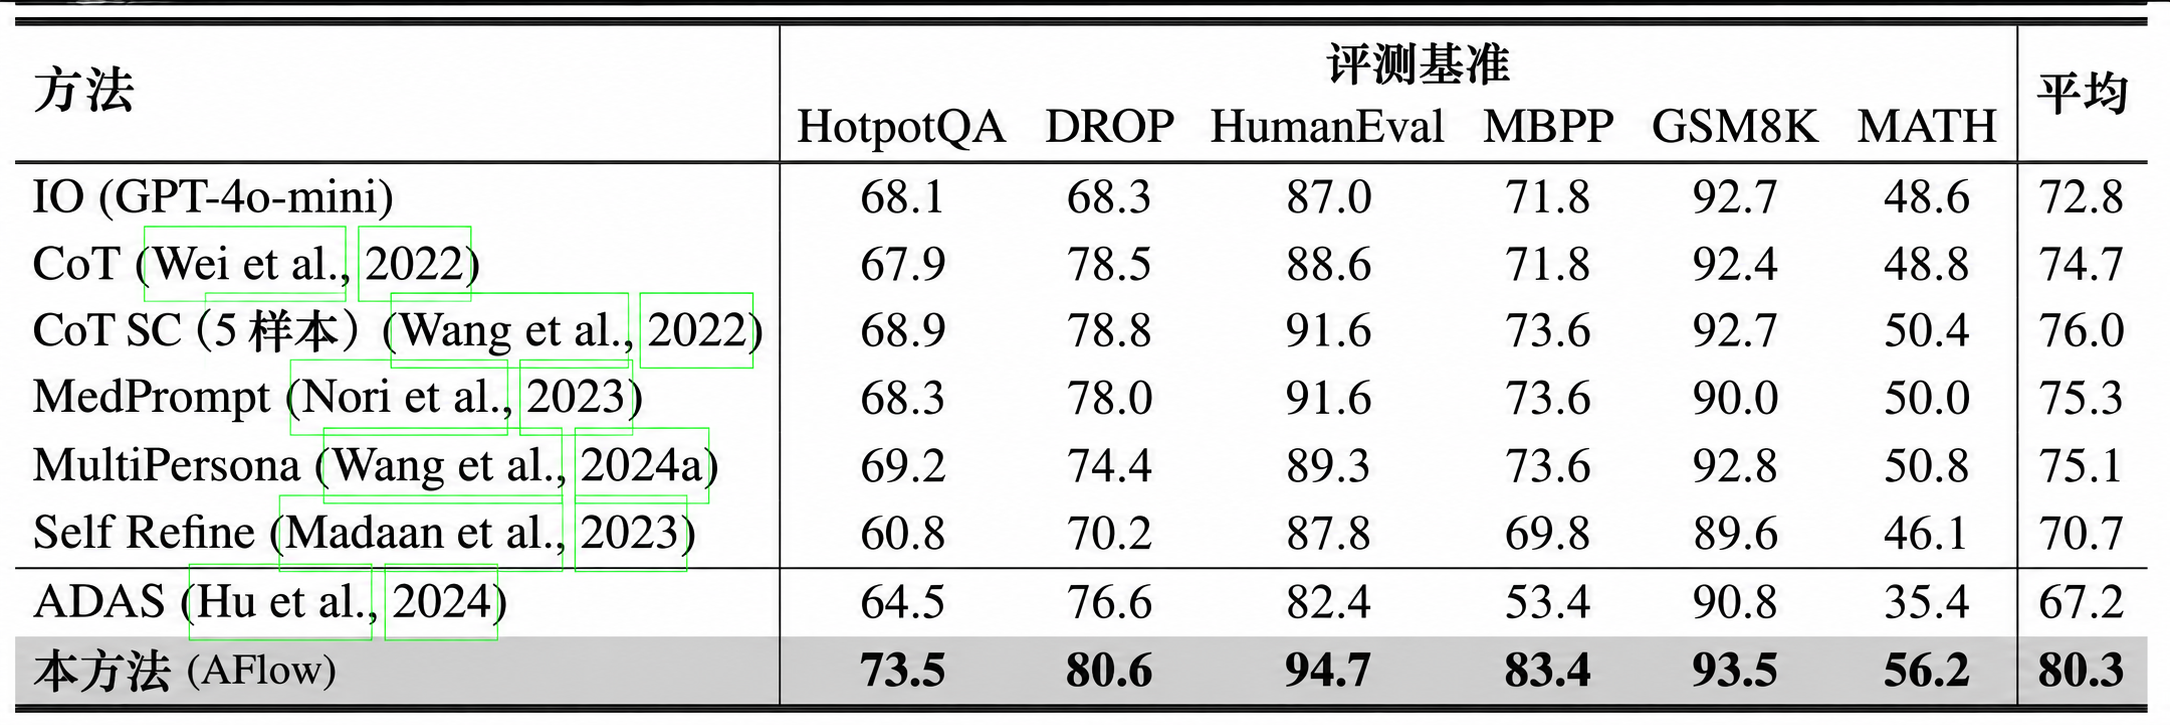
AFlow 与人工方法、ADAS 的实验比较。图片来源:Zhang 等,2025。
能够自我改进的 Harness
上下文工程和工作流设计,都只是 Harness 的一部分。完整的 Harness 优化需要搜索整个设计空间,一起优化上下文管理逻辑、工作流、权限和其他组件。Meta-Harness、ADAS、AFlow 等工作已经展示,代码是定义程序和系统的通用语言。简单来说,Harness 就是用代码组织提示词、工具调用、子 Agent、控制流、记忆和工作流逻辑。如果大语言模型能够优化执行 Agent 的代码,就能探索比手写提示词大得多的设计空间。
Self-Taught Optimizer(STOP;Zelikman 等,2023)是递归改进外部支撑程序的早期例子之一。初始改进器接收一个初始解、一个效用函数,以及一个黑盒语言模型,返回改进后的解。STOP 的目标并非直接改进这个解,而是改进负责改进它的程序本身。
研究者用改进器在一组下游任务上的平均效用,定义它的“元效用”。由于改进改进器本身也是一个优化问题,因此可以根据元效用衡量上一版的表现,再通过自我改进更新,递归地产生新的版本。
在实验中,经过改进的改进器发现了多种策略,包括遗传算法、拆分后分别改进、基于多臂老虎机的提示词选择、模拟退火、调整采样温度,以及束搜索和树搜索。Harness 工作流也可以用同样的方式,被表示为一个待优化的对象。
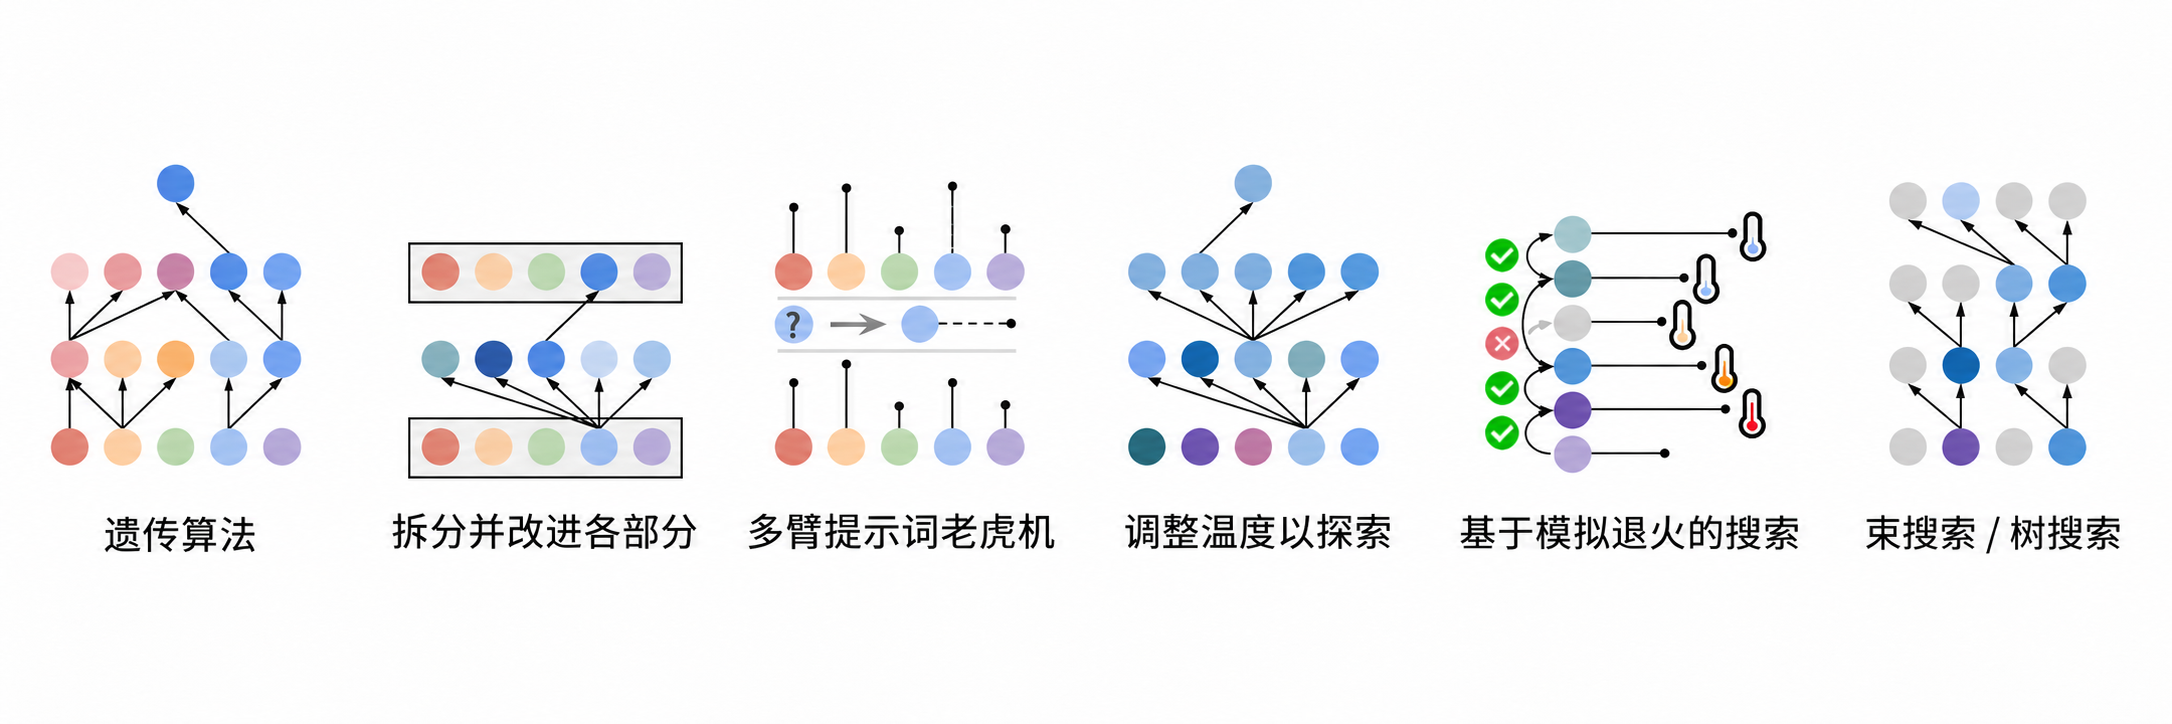
STOP 发现的自我改进策略示例。图片来源:Zelikman 等,2023。
Zelikman 等(2023)的结果中,有一点需要警惕:使用 GPT-4 时,STOP 的下游任务平均表现会随着迭代提升;换成 GPT-3.5、Mixtral 等较弱模型时,表现反而下降。仅有递归结构还不够,基础模型必须有足够能力,才能改进这套机制。这意味着,Harness 改进可以让模型得到更好的部署和使用,但智能本身仍然是核心。
Lin 等(2026)更细致地研究了 Harness 演化对模型能力的依赖,将它分为两个维度:Harness 更新能力,即能否产生有用的 Harness 修改;Harness 受益能力,即能否利用更新后的 Harness,更好地完成任务。有意思的是,实验中从 Qwen3.5-9B 到 Claude Opus 4.6,不同规模、不同基础能力的模型,表现出了相近的 Harness 更新能力。9B 模型作为 Harness 提案者或演化者,能够写出在流程结构上与 Opus 同构的 Skill。要充分利用 Harness,模型还需要在正确的时机准确调用 Skill 和工具,并能在长程任务中持续遵循指令。
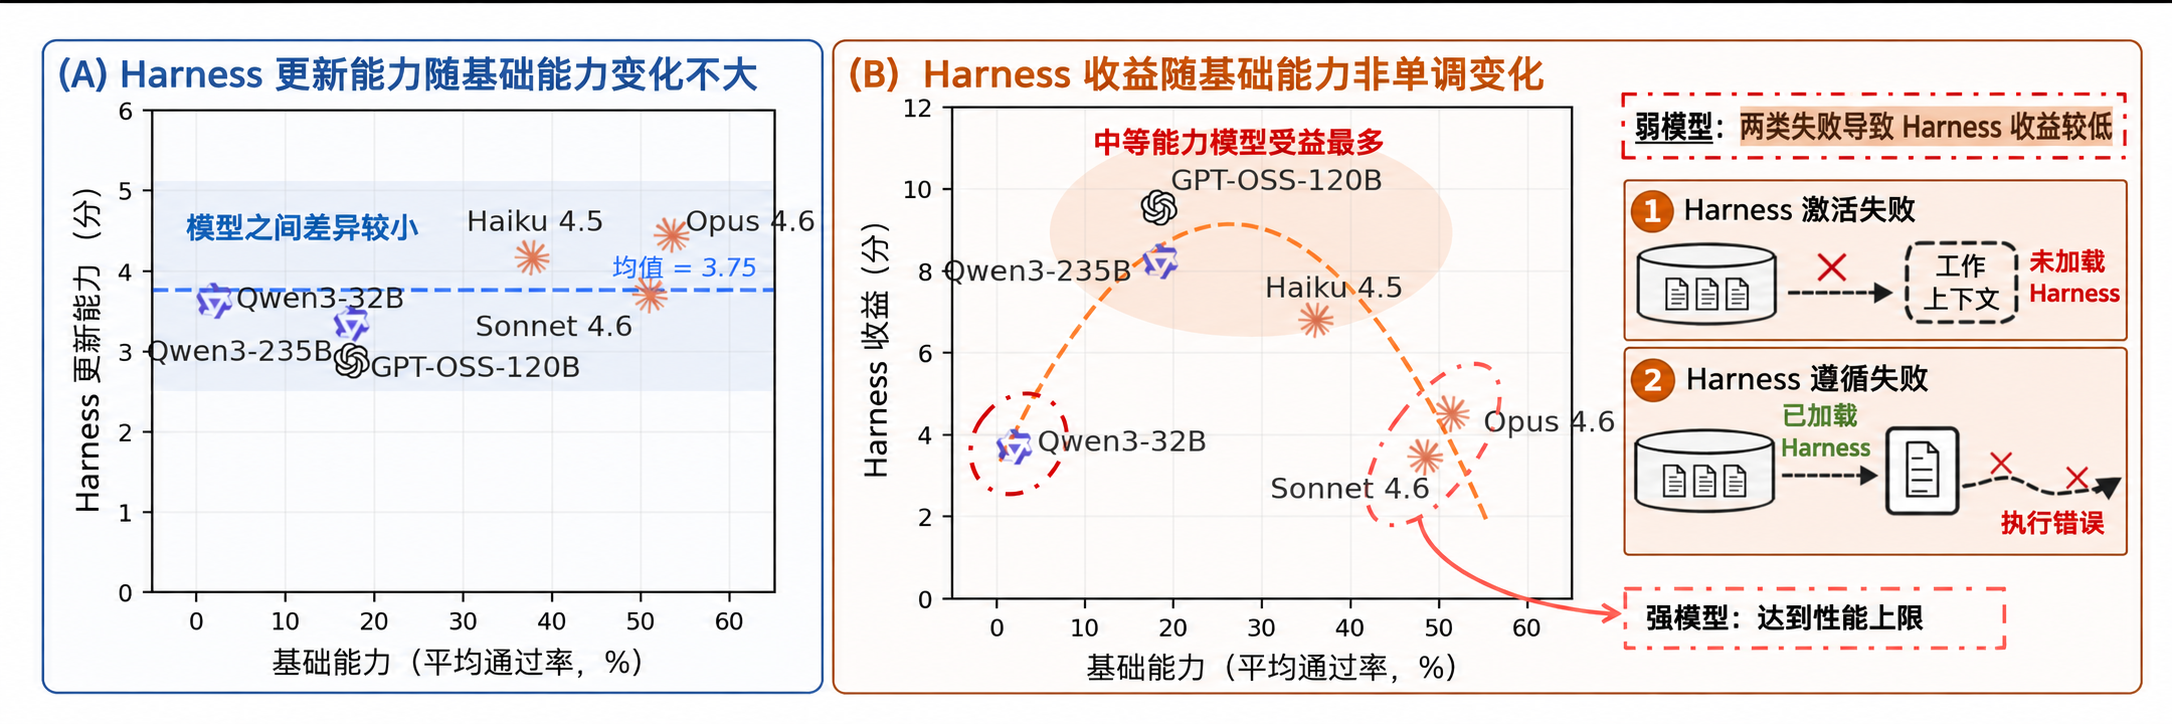
主要结果:A,从 Qwen2-32B 到 Opus 4.6,测得的 Harness 更新能力大致持平;B,Harness 受益能力并不单调变化,中等能力的模型获益最多。图片来源:Lin 等,2026。
较新的 Self-Harness(Zhang 等,2026)让大语言模型 Agent 通过“提出方案、评估、接受”的循环,改进自己的 Harness。
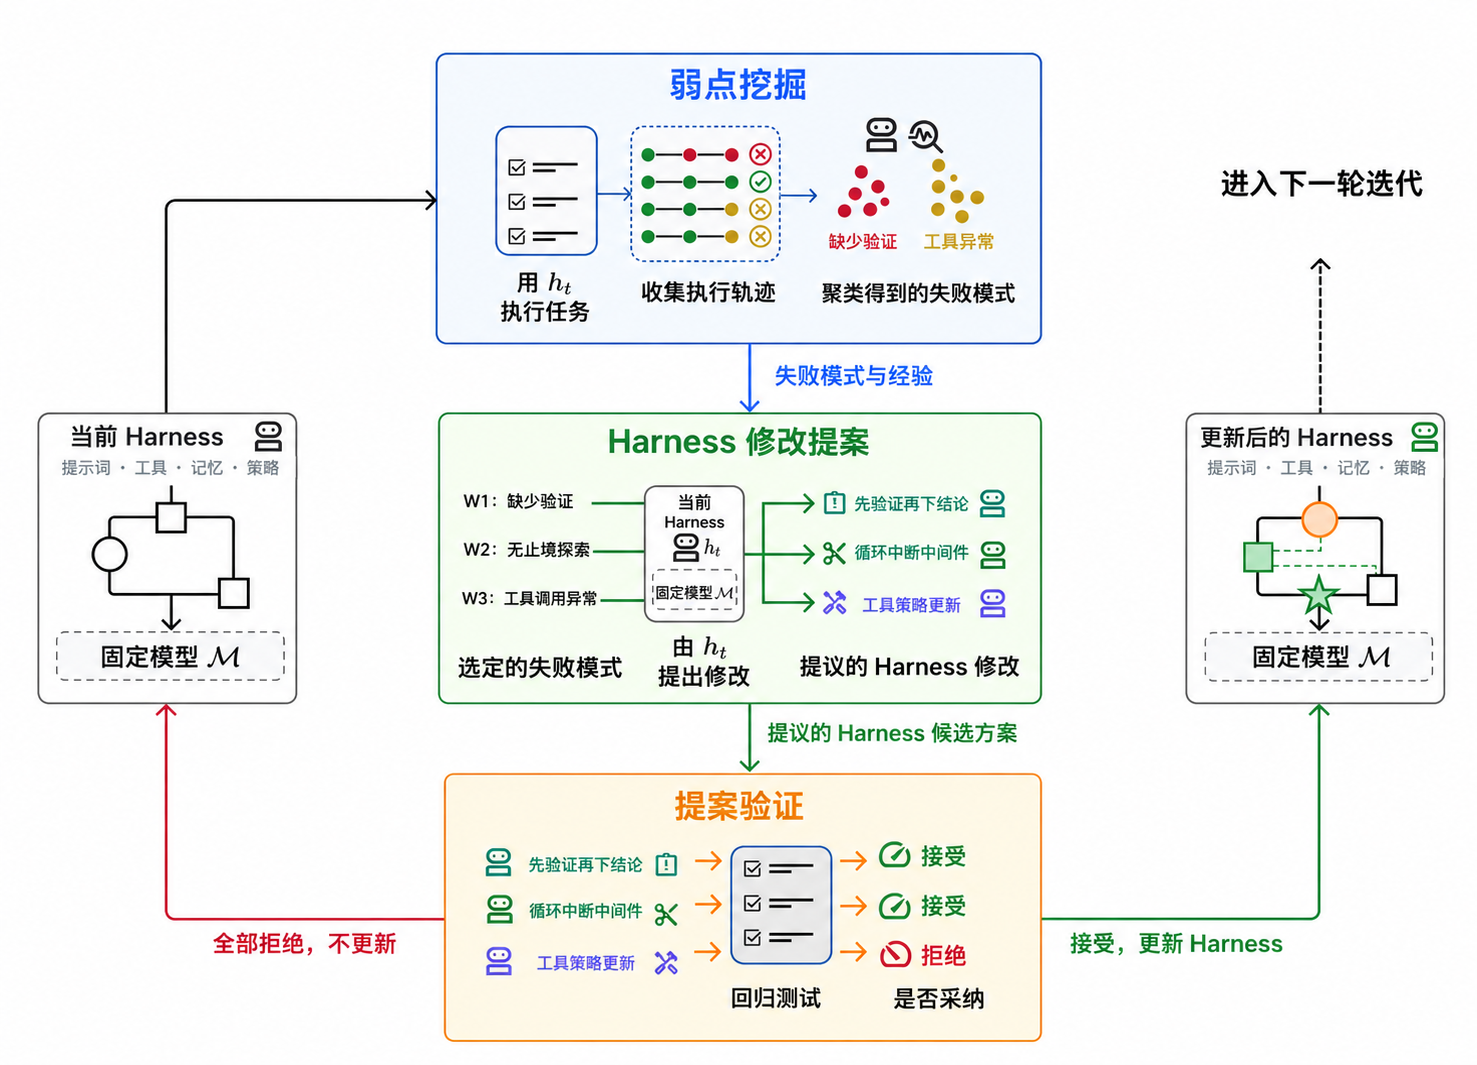
Self-Harness 通过挖掘弱点、在限定范围内提出 Harness 修改方案,以及验证,来更新 Harness。图片来源:Zhang 等,2026。
Self-Harness 的循环分为三个阶段。
第一阶段是挖掘弱点,将失败聚类为有验证器证据支持的失败模式。系统先用当前 Harness 执行评估任务,收集执行轨迹进行分析。两次运行可能在错误日志里呈现相同的验证结果,比如超时或缺少产物,但背后的原因并不相同。因此,失败记录需要包含足够丰富的信息:验证器最终判定失败的原因、相关 Agent 行为在因果链中的位置,以及轨迹暴露出的 Agent 机制,才能追查根因。
第二阶段是根据这些失败模式,在限定范围内提出 Harness 修改方案。系统仍在当前 Harness 下调用同一个模型,让它担任提案者。提供给模型的上下文有明确边界,包括当前 Harness 可编辑的部分、评估系统发现的失败模式、应当保留的成功行为记录,以及此前尝试过的修改摘要。修改应优先针对反复出现、能够解决的错误模式,例如可以通过小范围改动修复的问题,而非任务本身特有的难度。候选方案之间也应有所区别,保持多样性。
第三阶段是验证方案,将合格的修改合并为新的 Harness。候选修改会在两组数据上进行回归测试:一组用于检查已发现的弱点是否解决,另一组使用留出数据,检查是否引入了其他未知问题。只有在两组数据上都没有性能回退的候选,才会被接受并合并;被拒绝的方案会留下记录,但不改变正在使用的 Harness。
在 Terminal-Bench-2 上使用 MiniMax M2.5、Qwen3.5-35B-A3B 和 GLM-5 时,Self-Harness 学到了针对不同模型的 Harness 指令,分别处理它们的弱点,并提高了留出任务的通过率。
Self-Harness 这类工作也存在一个隐忧:如果允许程序修改操作系统,原有的抽象边界就被打破了。可编辑范围需要认真设计,权限控制和安全层应当留在这个循环之外。奖励投机带来的挑战也仍然存在。
Agentic Harness Engineering(AHE;Lin 等,2026)认为,Harness 演化的瓶颈在于可观测性:一次运行失败后,需要知道是哪个组件出了问题,每项修改也都应当有证据支撑。
它围绕三类可观测性构建闭环:
- 组件可观测性。 每个可编辑的 Harness 组件,在文件系统中都有对应表示,使可采取的操作清晰、可追踪。Harness 包含系统提示词、工具说明、工具实现、中间件、Skill、子 Agent 配置和长期记忆七类组件,每种失败模式都会映射到某个组件,让修改更有针对性。
- 经验可观测性。 将大量原始执行轨迹分析、整理成分层的证据和失败模式。每个 Harness 生成一批轨迹,每条轨迹单独存成文件,再由一个“Agent debugger”逐一分析,产出每项任务成功或失败的根因报告。这些报告汇总为基准测试概览,供下一步使用,必要时仍可查看原始轨迹。分层访问能更节省 Token。
- 决策可观测性。 每项修改都附带一个预测,留待下一轮验证。“Evolve agent”读取仓库,决定修改哪个组件,再生成修改及其理由。每项修改都是一个落实到文件层面、可以被证伪的主张,并受两项约束:修改只能发生在 Harness 工作区,运行记录目录、轨迹记录器、验证器和大语言模型配置均为只读,防止关闭验证器、更换模型或提高推理预算等作弊方式,使记录下来的收益可以归因于 Harness 修改;修改还必须有证据驱动,并在修改清单中注明失败证据名称、推断的根因、针对性的修复,以及预计能解决的问题和可能出现的性能回退。
在 Terminal-Bench-2 上,除 Hard 难度外,AHE 的表现超过了人工设计的 Harness(OpenCode、Terminus-2、Codex),也超过了几种自演化基线(ACE、TF-GRPO)。同一套 Harness 冻结后,无须继续演化,还能迁移到 SWE-bench Verified。这说明演化出的 Harness 能将工程经验写入组件,而不只是针对某个基准做优化。
演化搜索
演化搜索是一种受自然选择启发的优化方法,相关原理可以参考演化算法的文章。它通过对一组候选解进行变异,并保留其中适应度较高的成员,让整个种群不断演化。当搜索空间很大或形状不规则,难以直接用梯度优化,但候选解又容易评估时,演化搜索尤其有用。Harness 搜索似乎很适合这种方法。
过去的研究已经将演化搜索用于提示词工程。Promptbreeder(Fernando 等,2023)通过多种变异操作,优化特定任务的提示词;更有意思的是,用来指导大语言模型修改任务提示词的“变异提示词”,本身也会通过演化得到改进。GEPA(Agrawal 等,2025)将基于反思的提示与演化搜索结合,用自然语言分析反复尝试的轨迹,提出提示词更新方案。
Novikov 等(2025)提出的 AlphaEvolve,是一个基于编程 Agent 的演化搜索系统。它保存一组候选程序,让权重冻结的大语言模型生成改进代码的补丁。系统反复评估新产生的程序,保留成功的候选,逐渐找到更好的解。
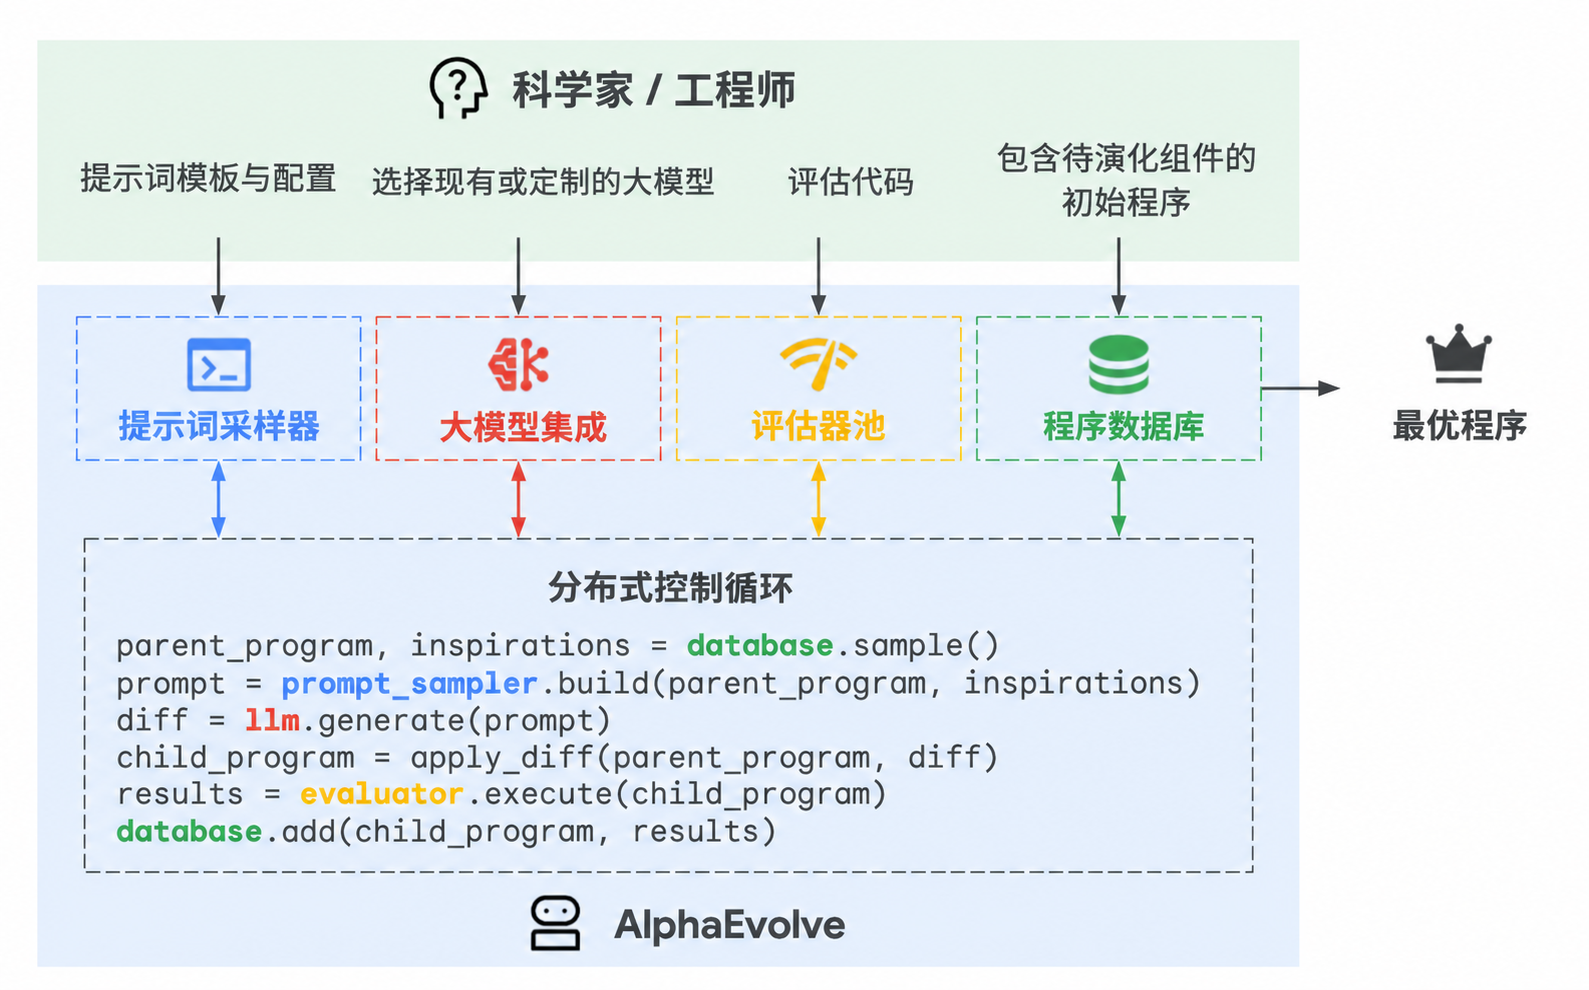
AlphaEvolve 的工作方式。图片来源:Novikov 等,2025。
AlphaEvolve 的设计中有几个值得关注的细节:
- 提示词包含父代程序、运行结果、指令,有时也包含元信息。
- 编程 Agent 可以访问整个仓库,但允许改进的代码区域会用
# EVOLVE-BLOCK-START和# EVOLVE-BLOCK-END明确标记。 - 元提示词按照大语言模型的建议,与指令和上下文共同演化,方式与解程序的演化相似。
消融实验展示了演化过程、提示词中的上下文、元提示词、整文件演化,以及更强大语言模型等设计的作用。
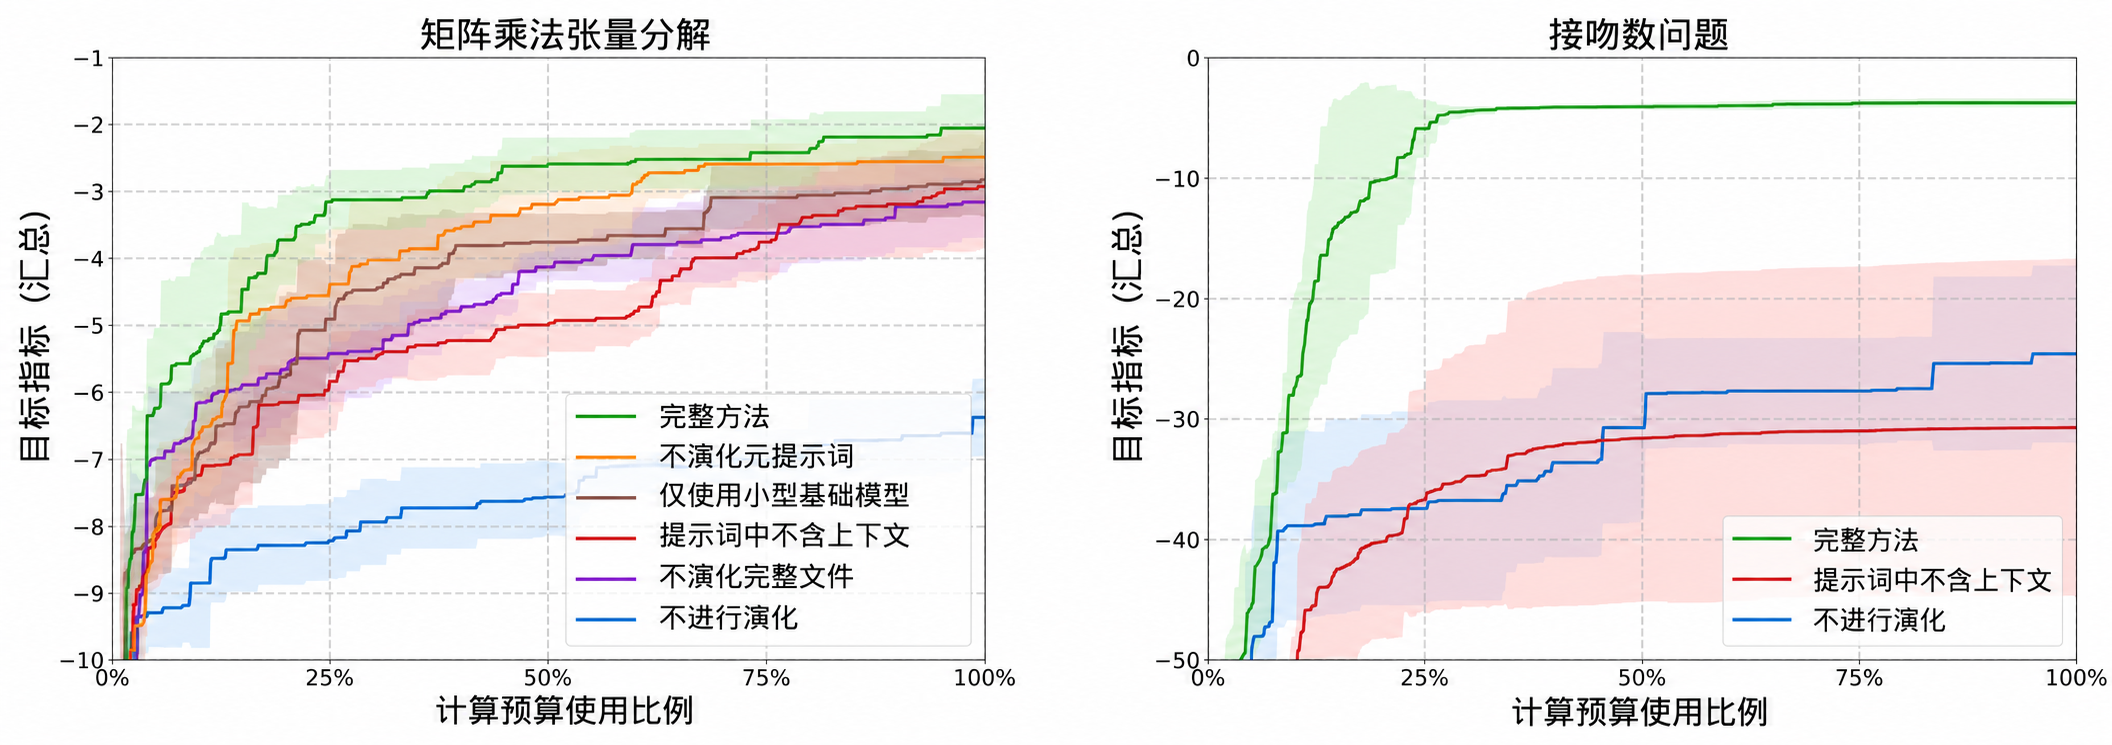
消融实验展示了 AlphaEvolve 中几项设计的价值。图片来源:Novikov 等,2025。
近期的一些变体中,ThetaEvolve(Wang 等,2025)将演化搜索与强化学习、上下文学习结合;DemoEvolve(Che 等,2026)在自身执行轨迹的档案中加入人类专家示范,为 Harness 层面的诊断和修改提供参考经验。ShinkaEvolve(Lange 等,2025)则引入了三个组件,提高大语言模型的采样效率:
- 选择父代时,兼顾性能排名和已有后代数量,让探索更高效地利用样本。
- 根据嵌入向量的余弦相似度,拒绝与现有种群过于相似的代码候选。
- 在元层草稿记录中,整理成功方案中的有效模式,指导后续变异。
上述方法主要关注解本身的改进,Darwin Gödel Machine(DGM;Zhang 等,2025)则明确以可编辑的 Harness 代码仓库为演化对象,使用基于大语言模型的编程 Agent,并允许这个 Agent 修改自己的 Harness。后续的 Hyperagents(Zhang 等,2026)引入了一个元 Agent,控制如何修改现有任务 Agent,生成新的 Agent。
- 候选池最初只有一个编程 Agent。
- 每轮选择一个父代进行修改、分支,产生新的 Agent。选择概率与表现成正比,与已有后代数量成反比。
- 被选中的父代检查自己的基准评估日志,对自身 Harness 代码库提出改进,生成新版本的编程 Agent。代码编辑通过两个基础工具完成:
bash,参数为<bash_command>;以及editor,参数为view/create/edit <file_path>。 - 评估新的编程 Agent,只有表现足够好的候选才会加入候选池。
- 重复第二至第四步,直到满足停止条件。
DGM 在模型固定的情况下演化 Harness。实验以 Claude 3.5 Sonnet 为基础模型,从简单的 Harness 配置出发,找到的 Agent 能与人工设计的 Agent 持平,或超过它们:SWE-bench Verified 上的表现从 20% 提升至 50%,Polyglot 上从 14.2% 提升至 30.7%。
当候选解可以自动评估、适应度容易量化时,这类方法表现较好,例如矩阵乘法、GPU 内核优化、算法竞赛和数据中心调度。如果某个领域的评估缓慢、含糊,或者主要依赖启发式判断,它们就会遇到困难。演化过程的计算效率和实际效果也仍然值得关注。
与模型权重联合优化
Harness 演化改变的是模型周围不涉及参数的系统。为了实现完整的自我改进,也可以同时允许模型更新自身权重。权重更新可以通过改进模型训练流程实现,也可以通过测试时的持续学习完成。持续学习是一个独立的研究主题。
SIA(Hebbar 等,2026)是较早尝试将 Harness 改进和模型参数更新放进同一个优化循环的工作之一,设计中包含三个组件:
- 元 Agent 提出初始 Harness。
- 任务专用 Agent 执行任务。
- 反馈 Agent 根据近期执行轨迹,决定更新 Harness 还是模型权重。
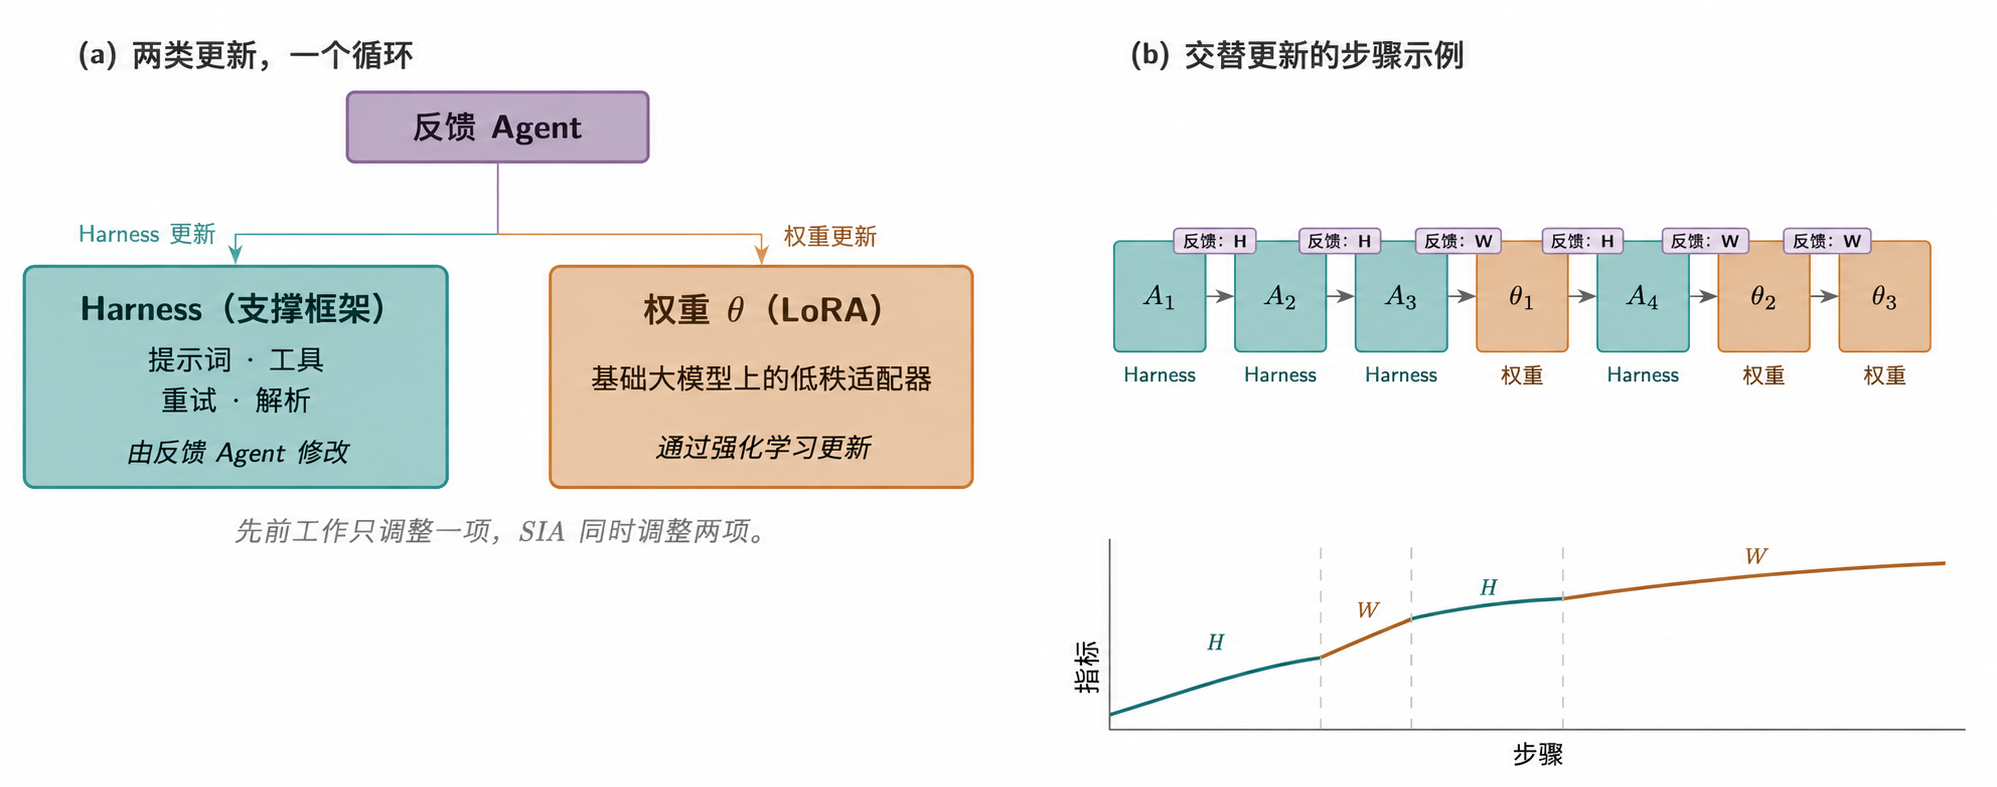
SIA 的反馈 Agent 决定下一轮迭代采用哪种更新方式。图片来源:Hebbar 等,2026。
SIA 实验中的几项设计使结果不太容易解释。例如,任务专用 Agent 使用的模型远弱于元 Agent 和反馈 Agent,前者是 gpt-oss-120b,后两者使用 Claude Sonnet 4.6;基线也较弱,难以与相关方法作清晰比较。这一方向值得关注,但现有证据还只是初步的。训练稳定性、古德哈特效应等许多问题也仍未解决。
Continual Harness(Karten 等,2026)在长程游戏任务中进行了实验,一边更新 Harness,一边用强教师模型为低奖励轨迹提供的标注进行蒸馏,共同训练策略模型。
未来的挑战
AI Scientist 这一系列工作有力地展示了,由专家设计的 Harness 能够组织自动研究循环中的大部分环节,相关实验以撰写研究论文的形式展开。但产出论文并不等同于科学发现。系统可以写出一篇看起来像样的稿件,同时仍然存在引用捏造、实现偏离原方案,或实验结果不足以支撑结论的问题。
Trehan 与 Chopra(2026)测试了一个问题:只提供最少的支撑框架和基础工具,大语言模型能否从研究想法出发,完成一篇论文?工具只有 read_file、write_file、llm_search 和 list_files,每个想法都有专用工作区,Agent 可以生成、读取文档,将其用作上下文。实验涉及世界模型、多 Agent 强化学习、AI 安全与对齐三个领域,每个领域提供 45 至 50 份高质量种子文档,启发新的研究想法。人类专家最终只选出四个想法进入完整流程,其中只有一个完整执行并写成论文。实验中反复出现了六类失败:
- 偏向训练数据中的默认做法。 使用旧库、过时命令、惯常格式,或采用没有根据实际仓库、数据集核实的假设。
- 执行压力下的实现偏移。 当实现变得复杂时,模型可能转向更常见、更简单的方案,而不再坚持原先提出的方法。
- 记忆和上下文退化。 在长程项目中,如果日志没有作为持久产物保存,重要细节就会丢失。
- 过于乐观。 即使实验充满噪声,甚至已经失败,模型仍会宣布成功。Bubeck 等(2025)也观察到类似的“p-hacking 和 eureka-ing”现象:模型用数值上的临时修补拼凑结果,在信号仍然只是噪声时就宣告胜利。
- 领域能力不足。 模型缺少隐性的专业经验,例如预判实现复杂度、判断实验结果是否合理,或知道哪些基线值得比较。
- 科研品味不足。 实验虽然能运行,却没有回答应该回答的问题。
研究者在通往完整 RSI 的道路上已经取得实质进展,但仍有几个瓶颈。
1. 评估器能力不足,标准也不够清晰。 许多研究主张没有快速、准确的验证器,现实世界中的许多任务也是如此。当前的自我改进循环,最适合评估指标可测量、客观的任务,这与强化学习的情况相似。
科研品味、新颖性和长期科学价值要难衡量得多。例如,科研品味往往涉及如何界定问题、设计实验,以及判断哪些意外结果值得继续追究,哪些失败值得再试。
2. 上下文和记忆的生命周期。 随着 AI Agent 越来越自主、独立,记忆会不断增长。一个有用的 Harness 需要管理上下文和记忆,弥补当前长上下文生成的局限,同时尽可能提高长程任务的成功率。参照人类终身维持记忆的能力,上下文工程有望、也应当成为智能本身的核心组成部分,而不只是停留在软件系统层。
3. 负面结果。 研究者更有动力发表成功结果,因此文献天然偏向成功。大语言模型使用海量数据训练,而这些数据至少到目前为止还主要由人类创造。成功与失败案例的失衡,可能使模型不擅长判断何时应放弃假设、报告负面结果,甚至承认失败。研究型 Harness 应当让失败尝试容易被保留下来,因为从失败中学习,是缩小任务搜索空间的最好方式。
4. 多样性坍缩。 演化和强化学习循环往往会不断利用已知的高奖励模式。需要相应的机制,防止整个种群退化成同一种方案的不同变体。对于开放式研究,这一点尤其重要,因为最好的路径在早期可能并不受当前评估器青睐。
5. 奖励投机。 自我改进循环会优化提供给它的任何信号。如果奖励来自单元测试,Agent 可能过拟合测试;如果来自评判模型,它可能学会专门针对这个评判者的投机技巧;如果来自基准分数,它可能利用基准本身的特征钻空子。
评估器和权限控制大概应当放在 Harness 演化循环之外,配合留出测试、轨迹审计,以及关键决策点的人类审查。监督能在多大程度上扩展和自动化,仍是一个开放的研究领域。
6. 长期成效。 外层优化循环处理的奖励,超出了训练沙箱中可模拟的单次执行轨迹。
以编程 Agent 为例,它们已经提高了软件工程的日常生产力,但许多优化目标仍然过于短期。Agent 往往能完成眼前的任务,至于如何维护一个由数百乃至数千名工程师共同开发的仓库的长期健康,就没有那么清楚了。标准的、基于沙箱的可验证奖励强化学习(RLVR)训练,很少覆盖可维护性、责任边界、迁移成本、向后兼容性和未来的调试负担。
7. 人的作用。 人类应当参与更高层次的工作,而不是被移出循环。人类需要在合适的时间、合适的抽象层次提供监督,系统设计也应当考虑何时、如何设置这些介入点。
上面许多挑战都需要人类的反馈和引导。技术发展的目的,是让人类拥有更好的未来,而不是反过来。
附录:一些有用的基准
PaperBench:从零复现 20 篇 ICML 2024 Spotlight 和 Oral 论文,包括理解论文贡献、开发代码库,以及成功运行实验。
- 每个复现任务都拆分成更小、可独立评分的任务。
- 与论文作者共同制定了 8,316 条评分细则。
- 当时表现最好的模型是
Claude 3.5 Sonnet,得分约 21%,没有超过机器学习博士。 - 包括 PaperBench、较轻量的 PaperBench Code-Dev,以及 JudgeEval。
CORE-Bench:评估已发表研究的计算可复现性。
- 基于计算机科学、社会科学和医学领域的 90 篇论文,构建了 270 项任务。
- 任务要求使用提供的代码和数据复现结果。
- 包含多个难度级别,以及纯语言、视觉语言两类任务。
- 当时报告的最佳 Agent 使用
GPT-4o和GPT-4o-mini,在最难任务上的准确率也只有 21%。
ScienceAgentBench:评估大语言模型 Agent 进行数据驱动科学发现的能力。
- 从数学、化学、生物和地理四个学科的 44 篇同行评审论文中,提取了 102 项任务。
- 覆盖这些领域的基础数据科学工作,包括数据处理、模型开发、数据分析和信息可视化。
RE-Bench:在贴近实际的机器学习研究工程环境中,将前沿 AI Agent 与人类专家比较。
- 包含 7 个有挑战性的、开放式的机器学习研究工程环境。
- 每个环境包含评分函数、初始方案和参考方案,使用不超过 8 张 H100 GPU 即可运行。
- 任务包括优化内核、开展扩展定律实验、修复嵌入表示、微调 GPT-2 完成问答等。
- 收集了 61 位不同的人类专家进行的 71 次、每次 8 小时的尝试。
- 在这些 8 小时尝试中,人类专家有 82% 取得非零得分,24% 达到或超过了较强的参考方案。
- 在 2 小时预算下,最好的 AI Agent 得分是人类的 4 倍;但随着时间预算增加,人类获得的收益更多,并在 8 小时和 32 小时设置下超过了 Agent。
MLE-bench:在离线 Kaggle 竞赛中评估机器学习工程 Agent。
- 从 Kaggle 精选了 75 场机器学习工程竞赛。
- 测试模型训练、数据集准备、实验运行,以及向评分脚本提交预测结果的能力。
- 使用 Kaggle 公开排行榜作为人类基线。
- 论文中的最佳配置,是
o1-preview配合 AIDE 支撑框架,在 16.9% 的竞赛中至少达到 Kaggle 铜牌水平。 - 还包含资源扩展和数据污染分析。
KernelBench:评估生成的 GPU 内核是否正确,以及运行速度如何。
- 包含 250 项 PyTorch 任务,用于检验大语言模型能否编写快速且正确的内核。
- 评估指标
fast_p统计生成的内核中,结果正确且速度超过基线的比例。
参考文献
[1] Good, I. J. “Speculations Concerning the First Ultraintelligent Machine.” Advances in Computers, 6:31–88, 1965.
[2] Yudkowsky, Eliezer. “Recursive Self-Improvement.” LessWrong, 2008.
[3] Choi, et al. “Anchored Self-Play for Code Repair.” ICML 2026.
[4] Zhao, et al. “Absolute Zero: Reinforced Self-play Reasoning with Zero Data.” arXiv preprint arXiv:2505.03335, 2025.
[5] Yuan, et al. “Self-Rewarding Language Models.” arXiv preprint arXiv:2401.10020, 2024.
[6] Chen, et al. “Self-Play Fine-Tuning Converts Weak Language Models to Strong Language Models.” ICML 2024.
[7] Zhang, et al. “Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models.” ICLR 2026.
[8] Ye, et al. “Meta Context Engineering via Agentic Skill Evolution.” arXiv preprint arXiv:2601.21557, 2026.
[9] Lee, et al. “Meta-Harness: End-to-End Optimization of Model Harnesses.” arXiv preprint arXiv:2603.28052, 2026.
[10] Lu, et al. “Towards end-to-end automation of AI research.” Nature, 651:914–919, 2026.
[11] Meng, et al. “ScientistOne: Towards Human-Level Autonomous Research via Chain-of-Evidence.” arXiv preprint arXiv:2605.26340, 2026.
[12] Kulikov, et al. “Autodata: An agentic data scientist to create high quality synthetic data.” arXiv preprint arXiv:2606.25996, 2026.
[13] Hu, Lu, and Clune. “Automated Design of Agentic Systems.” ICLR 2025.
[14] Madaan, et al. “Self-Refine: Iterative Refinement with Self-Feedback.” NeurIPS 2023.
[15] Zhang, et al. “AFlow: Automating Agentic Workflow Generation.” ICLR 2025.
[16] Zelikman, et al. “Self-Taught Optimizer (STOP): Recursively Self-Improving Code Generation.” COLM 2024.
[17] Zhang, et al. “Self-Harness: Harnesses That Improve Themselves.” arXiv preprint arXiv:2606.09498, 2026.
[18] Fernando, et al. “Promptbreeder: Self-Referential Self-Improvement Via Prompt Evolution.” arXiv preprint arXiv:2309.16797, 2023.
[19] Agrawal, A. et al. “GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning.” arXiv preprint arXiv:2507.19457, 2025.
[20] Novikov, et al. “AlphaEvolve: A coding agent for scientific and algorithmic discovery.” arXiv preprint arXiv:2506.13131, 2025.
[21] Lange, Imajuku, and Cetin. “ShinkaEvolve: Towards Open-Ended And Sample-Efficient Program Evolution.” arXiv preprint arXiv:2509.19349, 2025.
[22] Wang, et al. “ThetaEvolve: Test-time Learning on Open Problems.” arXiv preprint arXiv:2511.23473, 2025.
[23] Zhang, et al. “Darwin Gödel Machine: Open-Ended Evolution of Self-Improving Agents.” arXiv preprint arXiv:2505.22954, 2025.
[24] Zhang, et al. “Hyperagents.” arXiv preprint arXiv:2603.19461, 2026.
[25] Yuksekgonul, et al. “Learning to Discover at Test Time.” arXiv preprint arXiv:2601.16175, 2026.
[26] Riaz, et al. “Epistemic Uncertainty for Test-Time Discovery.” arXiv preprint arXiv:2605.11328, 2026.
[27] Hebbar, et al. “SIA: Self Improving AI with Harness & Weight Updates.” arXiv preprint arXiv:2605.27276, 2026.
[28] Trehan and Chopra. “Why LLMs Aren’t Scientists Yet: Lessons from Four Autonomous Research Attempts.” arXiv preprint arXiv:2601.03315, 2026.
[29] Bubeck, et al. “Early science acceleration experiments with GPT-5.” arXiv preprint arXiv:2511.16072, 2025.
[30] Starace, et al. “PaperBench: Evaluating AI’s Ability to Replicate AI Research.” ICML 2025.
[31] Wijk, et al. “RE-Bench: Evaluating frontier AI R&D capabilities of language model agents against human experts.” ICML 2025.
[32] Chan, et al. “MLE-bench: Evaluating Machine Learning Agents on Machine Learning Engineering.” arXiv preprint arXiv:2410.07095, 2024.
[33] Chen, et al. “ScienceAgentBench: Toward Rigorous Assessment of Language Agents for Data-Driven Scientific Discovery.” ICLR 2025.
[34] Siegel, et al. “CORE-Bench: Fostering the Credibility of Published Research Through a Computational Reproducibility Agent Benchmark.” TMLR 2024.
[35] Ouyang, et al. “KernelBench: Can LLMs Write Efficient GPU Kernels?” arXiv preprint arXiv:2502.10517, 2025.
[36] Lin, et al. “Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents.” arXiv preprint arXiv:2605.30621, 2026.
[37] Lin, et al. “Agentic Harness Engineering: Observability-Driven Automatic Evolution of Coding-Agent Harnesses.” arXiv preprint arXiv:2604.25850, 2026.
[38] Karten, et al. “Continual Harness: Online Adaptation for Self-Improving Foundation Agents.” arXiv preprint arXiv:2605.09998, 2026.
[39] Che, et al. “DemoEvolve: Overcoming Sparse Feedback in Agentic Harness Evolution with Demonstrations.” arXiv preprint arXiv:2605.24539, 2026.
原文出处
WENG L. Harness Engineering for Self-Improvement[EB/OL]. Lil’Log, (2026-07-04)[2026-10-29].