Appearance
一个远程 MCP Server 后面跑着四个实例,Client 在 A 上完成 initialize,下一次 tools/call 被负载均衡器发到 B,B 没见过这份 Session,只能把请求送回 A,或者先去 Redis 把 Session 读出来
这个细节直接决定 MCP Server 能不能像普通 HTTP 服务一样扩容、滚动发布和故障转移
MCP 在 7 月 28 日发布的新规范中删除了 initialize、initialized 和 Mcp-Session-Id,普通 Tool Call 不再依赖初始化,也不要求后续请求回到同一个 Server 实例
协议 Session 被删掉后,业务状态仍然存在,只是换了存放位置
协议版本和 Client 能力写进每个请求,浏览器上下文和数据库事务继续由业务 Handle 管理
状态要保存多久,决定它放在哪里
- Tool Call 等待用户补充输入时,Client 把
requestState带回 Server - 任务持续时间超过一次连接时,Server 用
taskId保存进度
8 月 22 日的路线图继续处理两个问题
- 连接断开后,任务完成通知发到哪里
- 新的 Agent 接手调用时,Server 怎样确认是谁在替谁做事
Webhook 对应通知投递,Agent Identity 对应身份和委托链,两者目前都还没有进入正式规范
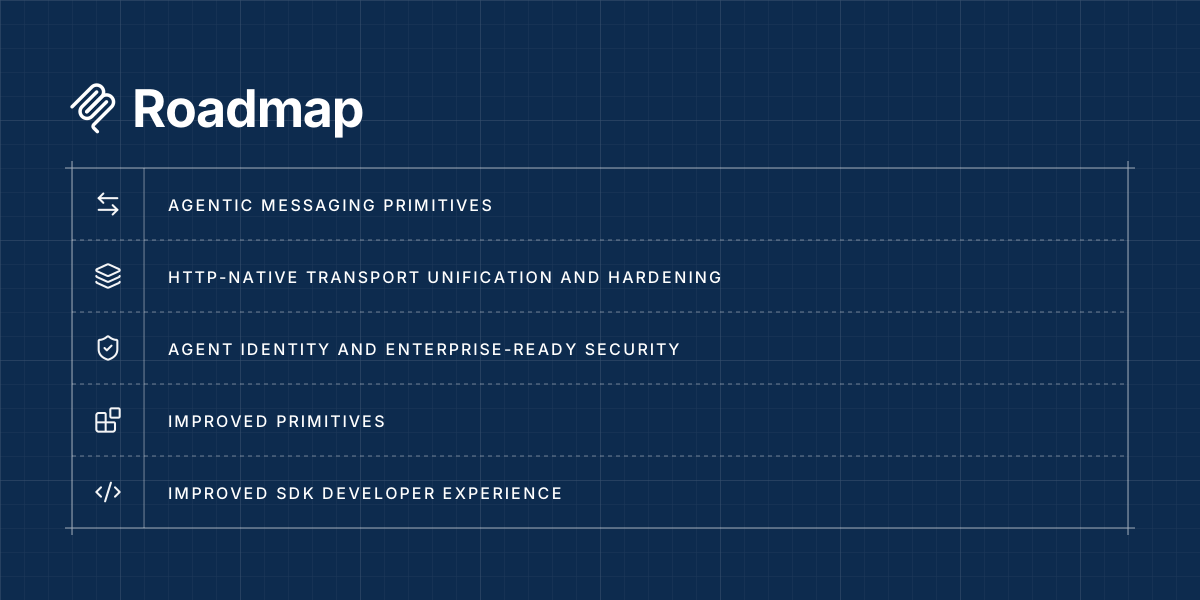
MCP 官方路线图原图,来源:The New MCP Roadmap
2026-07-28 版核心规范、Extension 和 8 月路线图分属三个成熟度
| 状态 | 内容 | 现在的处理方式 |
|---|---|---|
2026-07-28 版核心规范 | 无 Session、server/discover、MRTR、Subscription、缓存元数据 | 已发布,TypeScript、Python、Go、C# Tier 1 SDK 已支持 |
| Extension | Tasks、EMA、MCP Apps | 双方显式声明能力后使用 |
| 8 月路线图 | Webhook、HTTP over stdio、Agent Identity、Progressive Discovery、Tool Result 重构、生成 SDK | 未来六到十二个月的方向,接口仍可能变化 |
现在维护 MCP Server,可以先让请求随机落到任意实例,再决定哪些工作需要 MRTR、Task 或业务 Handle
路线图中的接口暂时不用猜,消息投递、委托身份和 Tool 发现已经可以按现有系统的规模开始评估
2026-07-28 版规范
Session 约束
本地 stdio 场景没有这个麻烦,Host 启动一个子进程,通过 stdin 和 stdout 交换消息,连接与进程一起创建、一起退出,把协议版本、双方能力和日志级别放在连接上,也会随着子进程一起回收
同一套设计搬到远程以后,Session 活得比处理请求的实例更久,2025-11-25 及更早版本要求 Client 先执行初始化,由 Server 创建 Session,再把 Mcp-Session-Id 交给 Client
text
initialize
    ↓
Server 返回 Mcp-Session-Id
    ↓
initialized
    ↓
tools/call + Mcp-Session-Id
Server 需要从这份 Session 里读取协议版本、Client 能力和日志级别,后续请求也就不能随便发给任意实例
负载均衡器看到 Mcp-Session-Id 后,只剩两种常见处理方式
- 使用 Sticky Session,让同一个 Client 一直落到同一台实例,热门 Client 会长期压在一台机器上,实例故障时绑定的 Session 也会失效
- 把 Session 放进 Redis 一类共享存储,每台实例在处理请求前读取,一个只有
search和fetch两个 Tool 的 Server 也要增加过期清理和并发更新
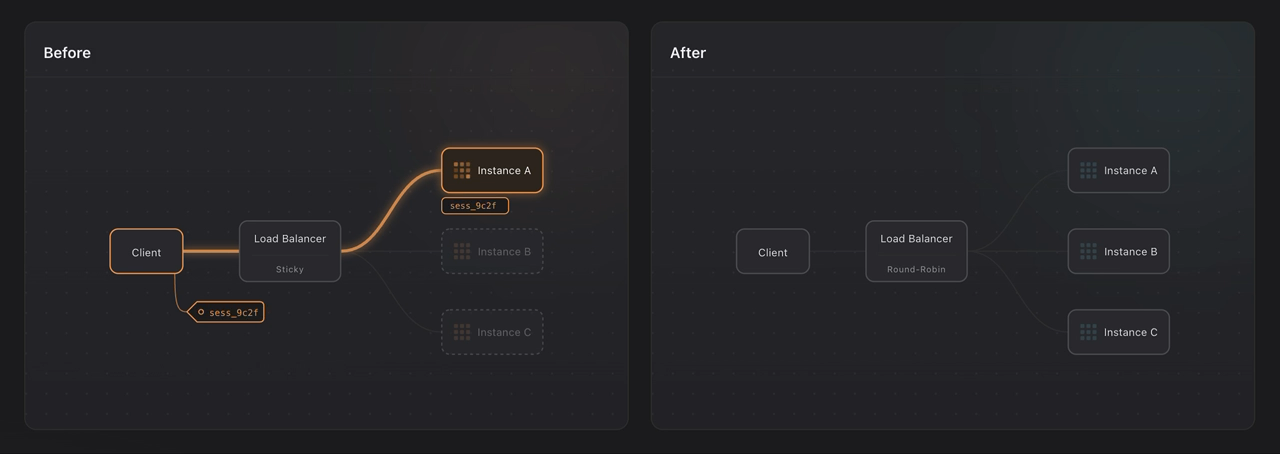
MCP 官方无状态核心演示静帧,原始动画见 stateless-core-demo.mp4,来源:The 2026-07-28 Specification
Request 自包含
协议 Session 被删除后,一次 Tool Call 不再要求预先执行 initialize,负载均衡器可以把它发给任何实例
http
POST /mcp HTTP/1.1
MCP-Protocol-Version: 2026-07-28
Mcp-Method: tools/call
Mcp-Name: search
Content-Type: application/json

{
  "jsonrpc": "2.0",
  "id": 1,
  "method": "tools/call",
  "params": {
    "name": "search",
    "arguments": { "q": "otters" },
    "_meta": {
      "io.modelcontextprotocol/protocolVersion": "2026-07-28",
      "io.modelcontextprotocol/clientInfo": {
        "name": "my-app",
        "version": "1.0"
      },
      "io.modelcontextprotocol/clientCapabilities": {}
    }
  }
}
协议版本、Client 信息和 Client 能力改为随请求发送,版本协商有两条失败路径
- HTTP Header 与
_meta中的版本不一致,Server 返回400 Bad Request - Client 请求了 Server 不支持的版本,Server 返回 JSON-RPC
-32022和支持的版本列表,Client 选择共同版本后重试
Server 必须实现 server/discover,Client 可以跳过发现,直接发起请求
这段请求已经带齐协议版本、Client 信息和 Client 能力,A、B、C、D 四个实例看到的是同一份输入,扩容和重启不再需要迁移协议 Session
状态拆分
SEP-2575 给无状态改造设定了一个顺序
- 请求能自包含时,Server 不保存协议状态
- 请求太大或业务必须保存状态时,Server 返回状态引用,Client 在后续请求中传回
- 前两种方式不够时,再考虑长连接或隐式状态
官方把这套顺序称为 pay as you go,一次搜索只支付一次 HTTP 请求的成本,只有确实要等待用户输入、恢复长任务或继续使用浏览器进程时,Client 和 Server 才保存对应状态
原来放在初始化和 Session 里的内容,现在分散到了不同位置
| 原来由 Session 承担的事情 | 2026-07-28 的处理方式 |
|---|---|
| 协议版本 | 随每个请求发送,HTTP Header 与 _meta 需要一致 |
| Client 名称、版本和能力 | 放进每个请求的 _meta |
| Server 版本和能力 | 通过 server/discover 按需查询 |
| Server 需要 Client 补充信息 | 用 MRTR 返回 input_required |
| 可以恢复的长任务 | 用 Tasks Extension 返回 taskId |
| 请求之外的通知 | Client 调用 subscriptions/listen 订阅 |
| 浏览器上下文、事务等业务状态 | Tool 返回显式 Handle,后续调用再传回 |
例如浏览器 Tool 打开一个需要登录的后台页面,可以返回 browserId = br_8f2c,后续截图、点击和关闭页面都把这个 ID 当参数传回来,Chrome 进程仍然运行在 Server,只是它不再藏在一份用途不明的协议 Session 里
有了 browserId,Server 可以明确记录它属于哪个租户、允许调用哪些浏览器 Tool、多久没有访问就回收,排查泄漏时也能找到是谁创建了这份浏览器上下文
Mcp-Session-Id 混合了协议协商、连接生命周期与业务状态,很难单独回答这些问题
取消和断线恢复也按这条边界重新划分
- HTTP Client 关闭当前请求的 SSE Response,Server 把这一次请求视为取消
- stdio 共用一条通道,Client 发送带 Request ID 的
notifications/cancelled - 旧版基于
Last-Event-ID的 SSE 恢复被移除,需要断线续跑的工作改用 Tasks
Streamable HTTP 增加 Mcp-Method 和 Mcp-Name,Gateway 不解析 JSON Body 也能按方法和 Tool 路由、限流
List 与 Resource Read 结果增加 ttlMs、cacheScope,并要求稳定排序,Client 缓存目录以后,上游 Prompt Cache 不会因为重连时的随机顺序失效
MRTR 与 Tasks
删除 Session 不会消除 Tool 与用户之间的多轮交互,文件删除 Tool 找到三个目标以后,仍然要等用户确认,只是 Server 不再沿着旧连接反向寻找 Client
旧协议会让 Server 沿现有连接反向调用 elicitation/create,远程实现需要保存 Client 连接,还要保证反向请求能重新找到它,很多 Server 因为这层成本没有实现 Elicitation、Sampling 和 Roots
MRTR 把这次暂停变成一个普通响应,核心类型只有两组输入输出和一份不透明状态
typescript
interface InputRequiredResult extends Result {
  resultType: "input_required"
  inputRequests?: InputRequests
  requestState?: string
}

interface InputResponseRequestParams extends RequestParams {
  inputResponses?: InputResponses
  requestState?: string
}
第一次 tools/call 返回 input_required 后已经结束,Client 把 requestState 原样保存
用户确认后,Client 使用新的 JSON-RPC ID 再调用一次原方法,第二次请求即使落到另一台实例也能继续,Server 不需要记住 Client 当时连在哪,也不需要恢复此前的 SSE 连接
requestState 经过 Client 再回到 Server,不能因为是自己生成的就直接信任,规范要求 Server 每次校验这段状态
里面若包含敏感数据或可执行步骤,实现时还应签名或加密,并绑定用户、过期时间和用途,否则另一个已认证用户可以重放拿到的状态,接管本不属于自己的半次 Tool Call
用户关掉 Client 后,文件删除可以一起放弃,这类交互用 MRTR
视频渲染、模型训练和 CI Pipeline 仍会占用 GPU、Runner 或外部队列,Client 退出不应该把已经运行两小时的工作一起丢掉,这些工作用 Tasks
Tasks Extension 为这类工作返回一个持久化 taskId,它更像一张可以重新查询的作业单
text
tools/call
   ↓
CreateTaskResult(taskId, status, ttlMs, pollIntervalMs)
   ├─ tasks/get       读取状态和结果
   ├─ tasks/update    提交补充输入
   ├─ tasks/cancel    请求取消
   └─ notifications/tasks
Tasks 不是所有 Client 都必须支持的核心能力,使用前要完成双方协商
- Client 在每个请求的
clientCapabilities.extensions中声明io.modelcontextprotocol/tasks - Server 通过
server/discover宣告支持 - 双方没有同时启用时,Server 不能返回
CreateTaskResult
Tasks 定义了 working、input_required、completed、failed 和 cancelled,Server 必须先把任务写入持久存储,再把 taskId 返回给 Client
在授权仍然有效并且 Task 没过 TTL 的前提下,用户第二天换一台电脑也可以继续查询
completed、failed 和 cancelled 都是终态,一旦进入就不能再修改
Tasks 的取消与通知有两个协议约束
tasks/cancel只表示 Client 请求取消,取消是协作式的,Server 确认收到请求后,Task 仍可能先完成,并进入completed- Polling 是默认机制,
notifications/tasks通过subscriptions/listen推送完整任务状态,但连接断开以后,Client 需要重新订阅
关掉 Client 就能区分 MRTR 与 Tasks:工作需要继续,把状态交给 Tasks;随着当前交互一起结束,就用 MRTR,由 Client 带着 requestState 回来
| 机制 | 状态位置 | 连接断开以后 |
|---|---|---|
| 普通请求与 Progress | 当前请求 | 请求取消,不恢复 SSE |
| MRTR | Client 持有 requestState | Client 重试原请求 |
| Tasks | Server 按 taskId 持久化 | Client 继续调用 tasks/get |
路线图
单个请求的边界已经在 7 月版规范中落定,8 月路线图继续讨论请求结束以后仍然存在的工作
- Messaging 与 Identity 影响远程 Agent 的长任务与授权
- HTTP over stdio 影响本地 Transport
- Progressive Discovery 面向 Tool 目录已经占用大量上下文的 Host
- Tool Result 与生成代码主要影响 SDK 实现
Messaging
Progress、MRTR、Tasks 和 Subscription 单独看都有定义,组合起来却会遇到真实的竞态
Task 正在等待输入时又收到取消请求,Server 先接受输入还是先取消,会直接决定这次工作最终进入 completed 还是 cancelled
Client 重连后的语义也没有写透,它可能只需要当前快照,也可能必须补齐断线期间的每一次状态变化,前一种适合展示最终状态,后一种才足够支撑计费、审计和外部工作流
路线图把这类组合检查放进 Agentic Messaging,并继续推动 Tasks 进入核心规范,只统一方法名还不够,状态转换没有统一,几个 SDK 仍会给出不同结果
当前 subscriptions/listen 仍然由 Client 发起,HTTP Client 发出 POST,Server 保持一个 SSE Response,后续通知都从这条流返回,Subscription 的生命周期因此仍然绑在 Client 进程和连接上
人工审批很容易超过这条连接的生命周期,Task 在下午三点进入 input_required,审批人晚上八点才操作,每十秒轮询一次会产生 1800 个大多没有变化的请求,维持一个五小时的 SSE 连接也未必能穿过所有 Gateway 和超时设置
路线图因此提出 Channel 和 Webhook,让 Server 在 Task 完成或需要输入时重新通知 Client
Server 从被调用方变成事件发送方以后,这些尚未定稿的接口至少要回答四组问题
- 谁能注册回调地址
- Server 怎样签名,Client 怎样验签
- 失败怎样退避,重复事件和乱序事件怎样处理
- Token 何时轮换
Task 已经保存执行状态,Webhook 只负责投递变化通知,两项职责如果混在一起,Server 又会依赖一条持续存在的连接
HTTP over stdio
到 7 月版规范,MCP 已经依赖多项 HTTP 语义
- 协议版本、方法和 Tool 名称放在 Header
- 错误同时使用 JSON-RPC Code 与 HTTP Status
- 缓存接下来还要增加 ETag
一个最小的 stdio Server 现在可以只做两件事,从 stdin 读一行 JSON,再向 stdout 写一行 JSON,它没有 Header、Status Code 和 HTTP Cache,SDK 只能把远程协议新增的语义重新映射进 JSON-RPC 消息
路线图准备试验 Streamable HTTP over stdio,并考虑使用 HTTP/2 多路复用,Host 仍然启动本地子进程,Server 也不用监听端口,stdin 和 stdout 里传输的内容却从一行 JSON 变成 HTTP framing
text
本地:Host -> HTTP over stdin/stdout -> Server 子进程
远程:Host -> HTTP over TCP/TLS      -> Server 或 Gateway
两种 Transport 使用相同的 HTTP framing 后,SDK 可以复用路由、错误、缓存、取消和流处理;代价是 HTTP/2 framing、流控和多路复用也会进入原本只需读写 JSON 的本地 Server
方案还没有定稿,现有 Server 只需把 Transport Adapter 与 Tool 处理逻辑分开,别让业务代码直接读写 stdin,提前猜一种 HTTP/2 over stdio 报文很可能只是增加返工
Agent Identity
MCP 现有 OAuth 流程可以说明「哪个用户授权了这次访问」,用户登录并授权,Client 取得代表用户的 Token,然后调用 MCP Server
到了后台 Agent 和子 Agent,这份 Token 已经解释不了完整调用链
一个云端 Agent 代表员工读取文档,随后创建子 Agent 更新 Jira,审计日志如果只记录用户 Token,只会留下「Alice 更新了 Jira」
日志看不出哪个 Agent 进程执行、父 Agent 委托了什么权限、子 Agent 当时拿到了多大的 Scope
clientInfo.name = sales-agent 也补不上这块证据,请求方可以随意填写这个字段,它不能证明调用来自哪个 Pod,更不能证明这个 Pod 正在代表谁
路线图准备复用现有身份标准,把它们接成一条能够审计的委托链
Workload Identity Federation 用 Kubernetes、SPIFFE 或云平台签发的短期 JWT 证明「哪个工作负载正在调用」,这份 SEP 仍在讨论
稳定的 Enterprise-Managed Authorization 负责把企业用户的授权带进 Agent 进程
父 Agent 创建子 Agent 时,再用 RFC 8693 Token Exchange 换出一枚受众更窄、Scope 更小、有效期更短的 Token
DPoP 把这枚 Token 绑定到子 Agent 持有的私钥,Token 即使从日志或代理里泄漏,拿不到私钥的进程也不能直接重放
DPoP 只证明请求方持有 Token 绑定的私钥,不负责认证用户,也不会替 Server 判断某个 Tool 能否执行,租户、资源所有者和 Tool 副作用仍然要进入授权逻辑
一个运行六小时的任务可能经历多个 Agent 进程,查询、补充输入、取消和接收回调的进程也可能不同,如果只保存最初的用户 Token,审计日志无法还原后续动作由谁执行
Progressive Discovery
在 7 月版规范中,tools/list、prompts/list、resources/list 和 resources/read 的结果增加了 ttlMs 与 cacheScope,路线图中还包括 ETag,这些字段可以减少目录的重复下载
缓存不会减少模型看到的 Schema,若一个 Server 有 300 个 Tool,tools/list 即使命中本地缓存,Host 仍可能把 300 份名称、说明和 JSON Schema 交给模型
路线图尚未定义 Progressive Discovery 的方法名和 Schema,目前只有目标:Client 按需获取 Tool 与 Resource,不必在启动时读取完整目录
Anthropic 已经使用的 Tool Search 分两步暴露 Tool,先搜索候选 Tool,再展开完整 Schema
MCP 若采用同样的分层,需要在 Server 与 Client 之间定义查询、候选返回、Schema 展开和权限过滤,现有 Tool Search 仍是 Host 的私有接口
分页版 tools/list 仍然要求 Client 读完所有页,最终进入模型的 Tool 定义没有减少;Progressive Discovery 还要测试正确 Tool 能否进入候选集
完整列表给 Client 一个确定集合,渐进发现增加了 Server 的索引和排序,正确 Tool 如果没有进入候选集,后面的模型就没有机会选择它
一次错误调用发生后,需要用查询文本、Server 候选集、Host 展开的 Schema 和最终 Tool Call 还原过程,区分模型选错了,还是正确 Tool 没有被召回
权限过滤也要提前到发现阶段,一个用户无权调用的 Tool,名称和说明本身就可能包含敏感信息,Server 不能先完整暴露,再等到 tools/call 阶段拒绝
Tool Result 与 SDK
当前规范允许 tools/call 同时返回 content 和 structuredContent,为了兼容旧 Client,还建议把结构化结果再序列化成 TextContent,路线图准备重新定义两者的关系
json
{
  "content": [
    { "type": "text", "text": "{\"temperature\":22.5}" }
  ],
  "structuredContent": {
    "temperature": 22.5
  }
}
如果两份内容由不同代码路径生成,程序可能读到 22.5,模型却看到 23,脱敏逻辑也可能只处理其中一份
接口改动尚未确定,Server 现在可以先保留一个内部结果,由同一份数据生成文本和结构化输出
路线图中的 Generated Artifacts Experiment 会尝试从规范和人工审阅过的 Conformance Test 生成一个候选 Tier 1 SDK,再判断哪些层适合确定性代码生成,哪些层仍要人工或模型参与
生成器会直接暴露规范能不能推出唯一行为
tasks/cancel只确认取消意图,Task 仍然可能进入completed或failed,这条规则可以写进 Conformance Testcontent与structuredContent同时存在时,规范没有定义供模型阅读和供程序读取的优先关系,生成器只能猜测
猜测出现的位置应该回到规范处理,不能让四个 Tier 1 SDK 各自补一个答案
随机路由测试
Webhook、HTTP over stdio、Agent Identity 和 Progressive Discovery 还没有可以迁移的接口,现有 Server 可以先验证 2026-07-28 版规范定义的无状态边界
测试时启动 A、B 两个实例,关闭 Sticky Session,也不建立协议 Session 的共享存储,然后依次跑三组请求
- 让
server/discover落到 A,随后的tools/call落到 B,B 只能读取当前请求中的版本、Client 信息和能力,若它还需要 A 进程里的数据,无状态改造就没有完成 - 让删除 Tool 的第一次调用落到 A,A 返回
requestState,确认后的第二次调用落到 B,并使用新的 JSON-RPC ID,B 应当只靠第二次请求完成调用- 失败时检查
requestState是否带齐状态,以及滚动升级前后的 Tool 能否读取彼此生成的状态
- 失败时检查
- 让 A 创建一个 Task,拿到
taskId后直接杀掉 Client,再以同一授权主体启动新 Client,把tasks/get发到 B,在 TTL 内至少应返回working或一个终态- 查不到时,检查 Server 是否在持久化完成前就返回了 ID,以及 Client 是否把 ID 保存到了可恢复的位置
浏览器 browserId 一类业务 Handle 可以依赖共享存储,也可以显式绑定某个 Worker 并让路由层识别这种绑定,但必须单独定义三组保证
- 所有者与权限
- TTL 与幂等
- 回收规则
这些保证必须跟着 Handle 走,不能再借用协议连接的寿命
Tool 较多的项目现在还无法实现路线图中的 Progressive Discovery,却可以先建立一组固定任务,记录两组基线
- 成本:每次加载的 Schema tokens
- 质量:正确 Tool 是否进入前 K 个候选,任务最终是否成功
没有这组基线,以后即使接入了渐进发现,也只能看到接口变了,无法判断模型输入和 Tool 选择有没有改善
跑完以后,日志里至少要能回答四个问题
- 每份跨请求状态由谁保存
- 用什么 Handle 找回
- 何时过期
- 断线后怎样恢复
只要其中一个答案仍然依赖「同一个 Client 还连着同一台机器」,无状态改造就没有完成
参考资料
- Model Context Protocol, The New MCP Roadmap
- Model Context Protocol, Roadmap
- Model Context Protocol, The 2026-07-28 Specification
- Model Context Protocol, The 2026-07-28 Specification Release Candidate
- Model Context Protocol, SEP-2575: Make MCP Stateless
- Model Context Protocol, SEP-2567: Sessionless MCP via Explicit State Handles
- Model Context Protocol, SEP-2322: Multi Round-Trip Requests
- Model Context Protocol, Tasks Extension
- Model Context Protocol, Message Patterns
- Model Context Protocol, Tools
- Model Context Protocol, Enterprise-Managed Authorization
- Model Context Protocol, Exploring the Future of MCP Transports
- IETF, RFC 9449: OAuth 2.0 Demonstrating Proof of Possession
- IETF, RFC 8693: OAuth 2.0 Token Exchange
- Anthropic, Advanced Tool Use
路线图描述未来六到十二个月的优先工作,不是最终规范,HTTP over stdio、Server 主动事件、Agent Identity、Tool Result 和 Progressive Discovery 的接口仍可能调整