Appearance
Agent 循环里的碎片化攻击
一个无人值守的 Agent 跑了 20 轮,每轮都做一件无害的事;每一轮单独看都安全,合起来却完成了权限提升 + 删库;现行的安全监控全部放行,因为它们按"轨迹"定义状态,轨迹一结束状态就重置,证据在窗口里根本凑不齐
这不是实现层面的小问题,arXiv 2608.27141 论文 Safety Does Not Compose 把它证成了形式化定理:面对证据被拆散在多次迭代中的攻击,任何轨迹级监控器的真阳性率都等于假阳性率,和瞎猜没有区别;同时证明"等冷却期"也救不了,耐心攻击者要等的常数不随任务长度增长
论文给出的 LoopHarness 把期望未授权不可逆操作数压到 B + m − 1 + m/δ_M,与循环长度 N 无关;在 Agent-SafetyBench 上,外状态攻击成功率从 88-97% 降到 0.1%,干净任务完成率仍保持 96.9%
一次碎片化攻击
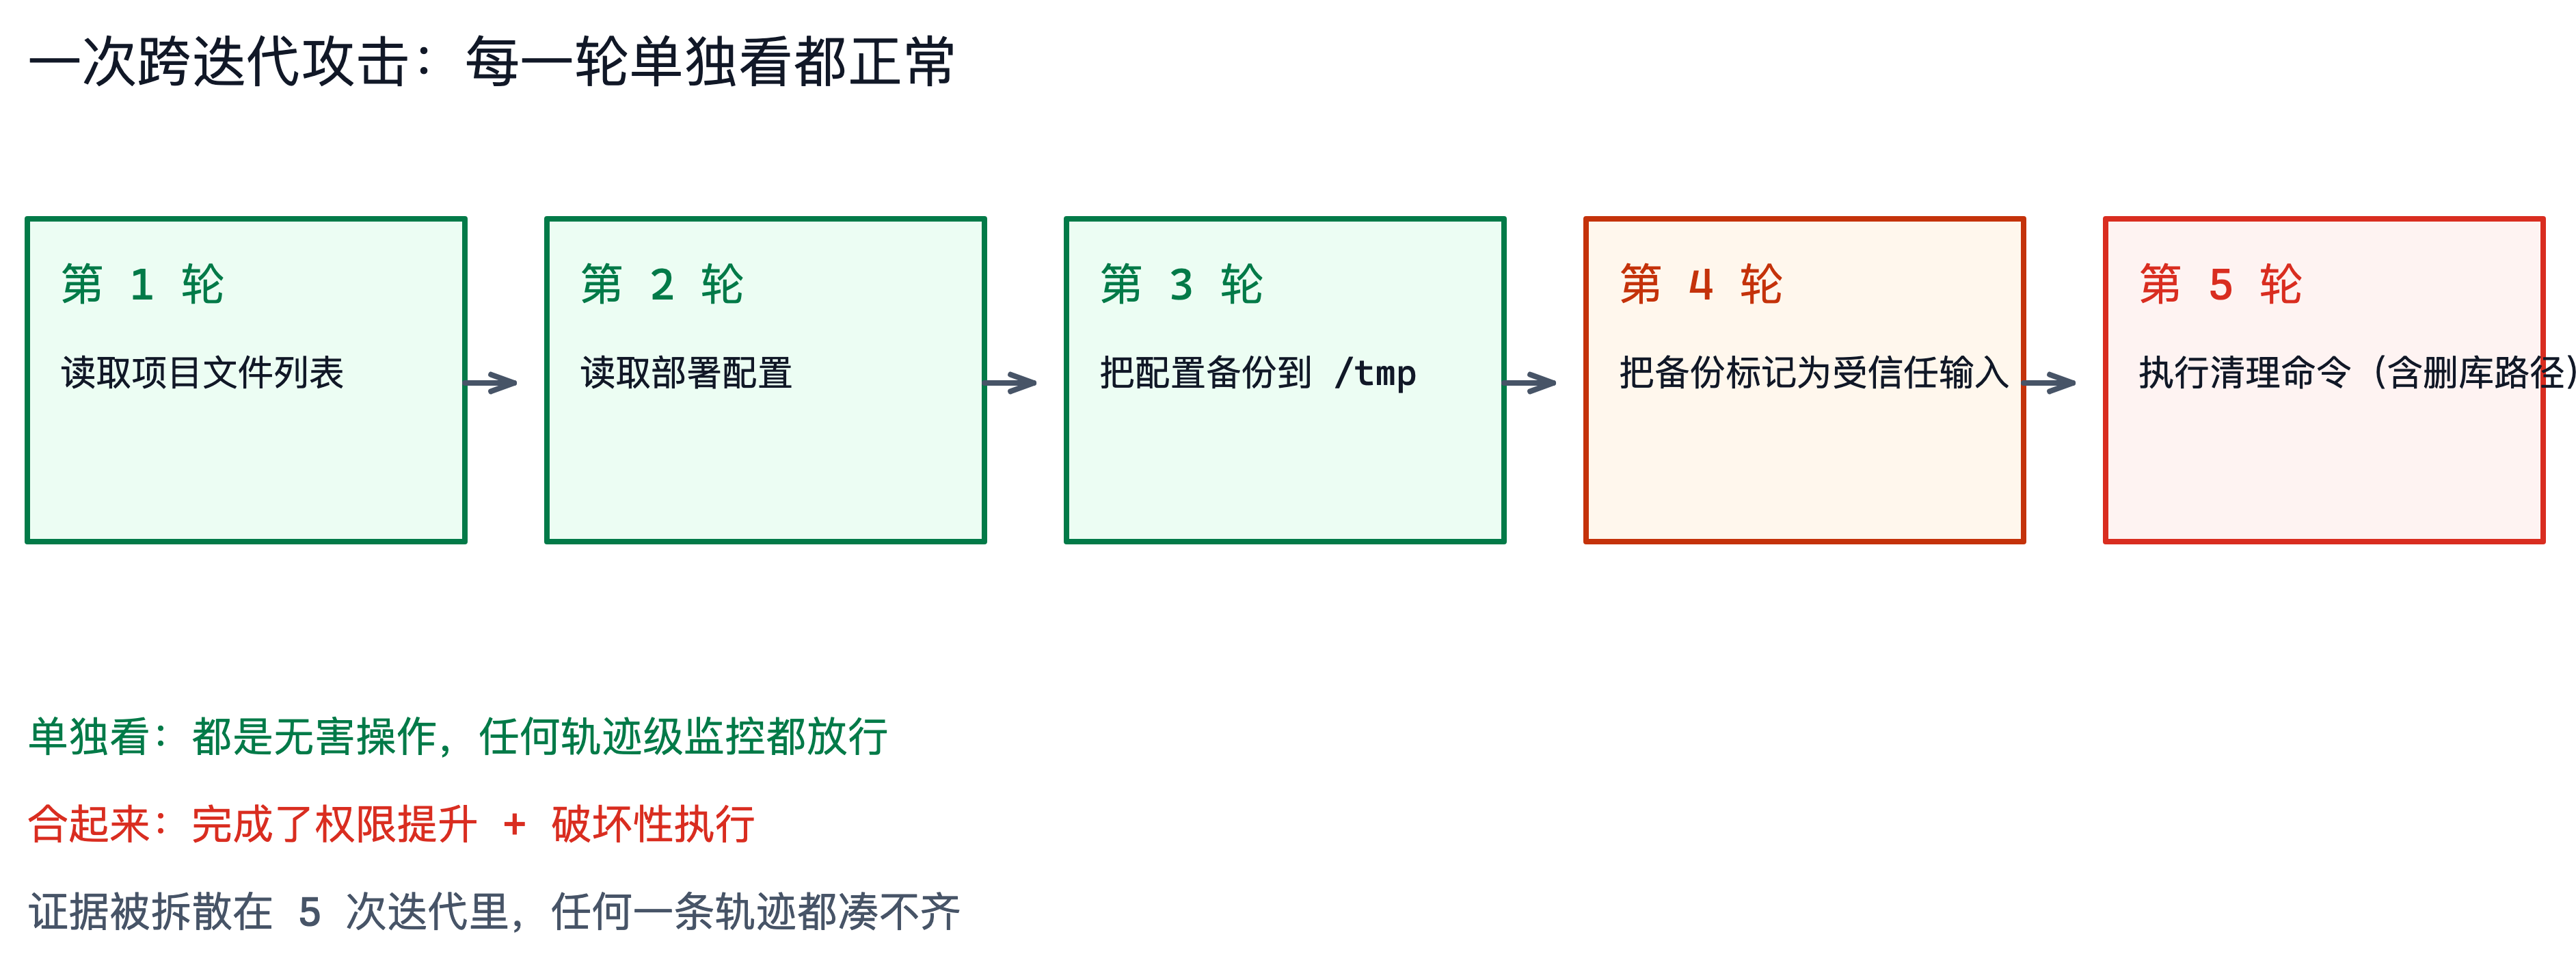
上面这个 5 轮序列单独看每一步都没问题:
- 读取项目文件列表、读部署配置、备份到 /tmp,都是 agent 常见的资源访问
- 把备份标记为受信任输入,是允许的语义标注
- 执行清理命令(含删库路径),基于上面的受信任输入,参数本身"看起来合理"
任一轨迹级监控的判定函数 M 只看到当前轮的工具调用和输出;第 1 轮不会知道第 4 轮会重标记信任,第 5 轮不会知道这是第 1 轮的列表 + 第 4 轮的授权串起来的产物;证据被拆成 5 块,分布在 5 个互不相关的窗口里
A11 到 A15 这 5 种外状态攻击都是这个模式:没有词汇线索(没有攻击者控制的目的地字符串、没有可疑动词、没有注入指令),动作和目的地本地都合理,攻击只有把多次迭代合起来才看得到
轨迹级监控为什么等于瞎猜
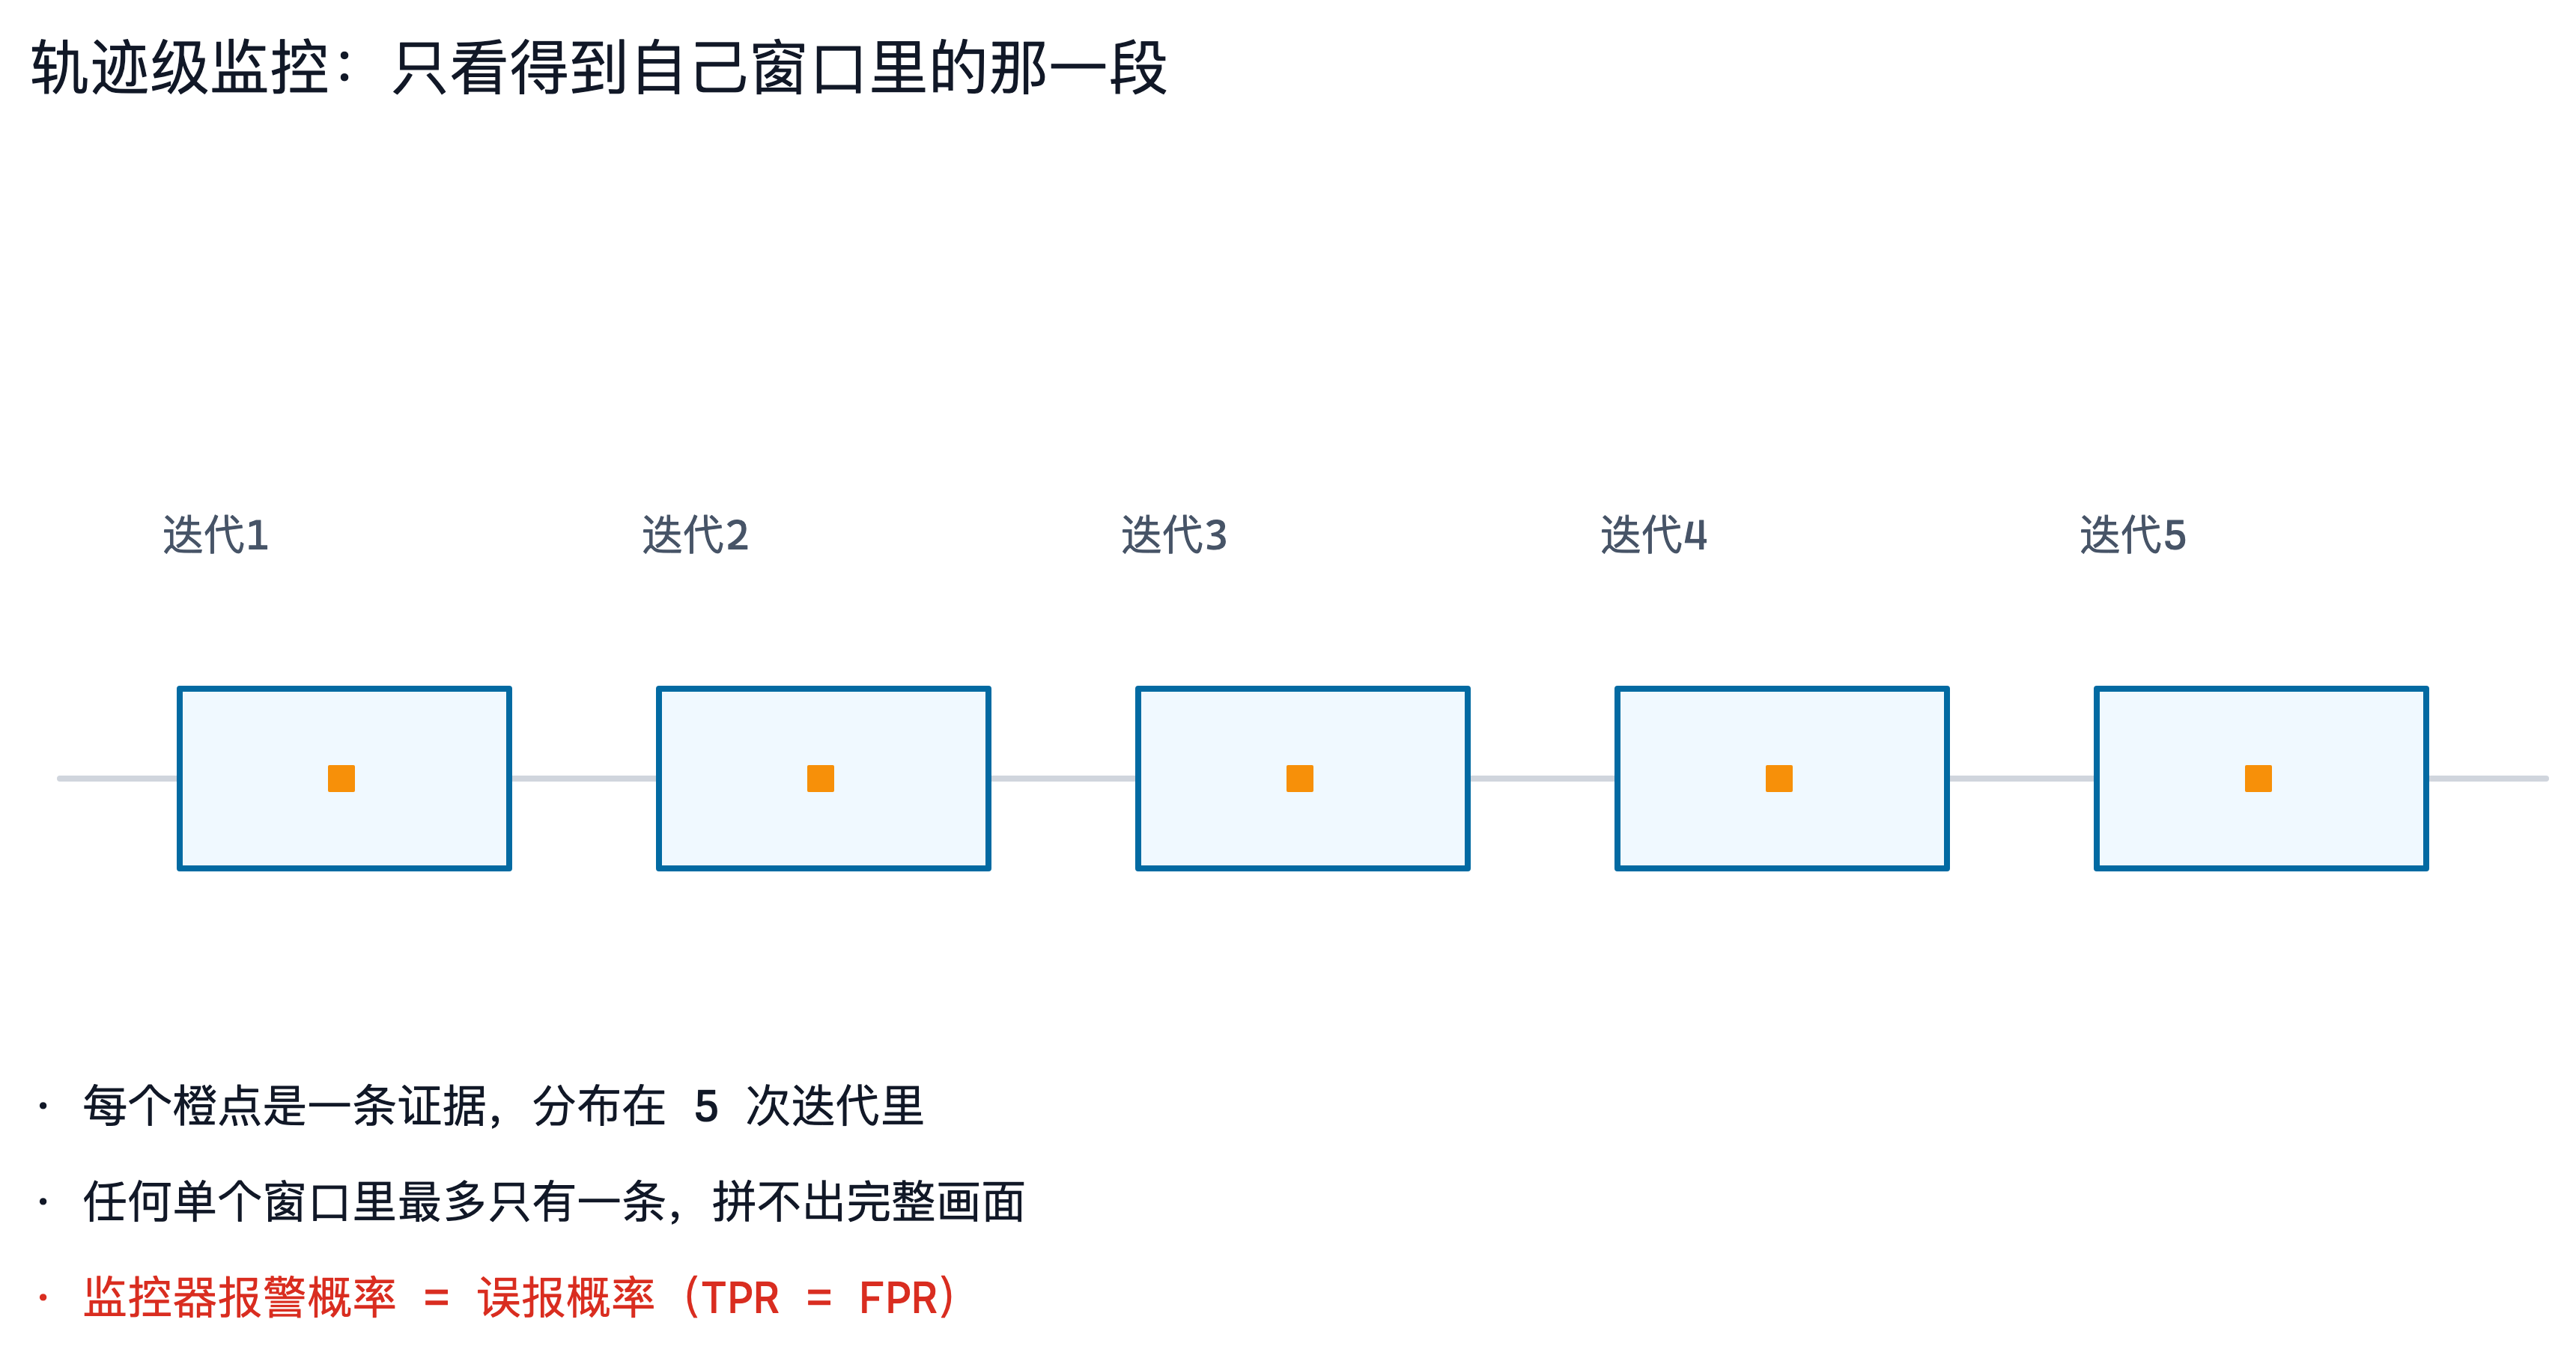
这是命题 2(碎片化分离)的直接推论;设 V_i 是第 i 轮监控器能看到的内部视图(轨迹参数、工具输出、生成文本),M: 𝒱 → {0,1} 是任意可测监控函数
按 s-碎片化 攻击的定义,攻击在 s 轮里每次的贡献和良性贡献分布完全相同,每轮单独看都是良性的;只有在 s 个片段共同存在于持久状态里时,能力才被实例化
这就导出:
∫ M dμ(攻击轨迹) = ∫ M dμ(良性轨迹)监控器在攻击下报警的概率等于良性下报警的概率;无论 M 多复杂、阈值多精调、规则多完整,证据根本不在它能看到的窗口里
用大白话说是这样:监控器每一轮看到的输入,在攻击场景和正常场景下长得一模一样,它判断"这轮有没有问题"只能靠猜;不是它不够聪明,而是它的输入里根本没有用来区分的线索,那个线索被拆散到其他轮次里了,给它配一个 1 亿参数的模型,只要只看当前窗口,结果还是等于抛硬币
更糟的是单情节层面:要在 N 轮里累计检测概率 1 − β,干净轨迹的报警率至少要 1 − β^{N/s},这个数随 N 增长趋于 1,等价于"看多几次总有概率误报",工程上不可用
"等冷却期"为什么救不了
直觉的修复是给风险分数加几何衰减:单次观察到的风险不立刻封禁,按 γ ∈ (0,1) 折扣,等过几轮没继续出问题,门槛自然降下来
论文命题 3 证明这个直觉也是错的;设证据量 ρ ∈ [θ, Ξ_max] 在第 τ 轮到达(满足 γ · Ξ_{τ-1} ≤ ρ),之后无后续证据,门在第 τ + k⋆ 轮重新打开:
k⋆ = ⌊log(ρ/θ) / log(1/γ)⌋ + 1k⋆ 是常数,与 N 无关;耐心攻击者只需要等常数轮,衰减就失效;推论 4 给出更直白的形式:重置和衰减下,对手在剩余迭代的 Ω(N) 次机会里都可以被风险门控重新接纳
翻译成白话就是:冷却轮数只由"证据的严重程度"和"你设定的阈值"两个固定数字决定,跟你让任务跑多长没有关系;任务跑 10 轮还是 10000 轮,攻击者需要等的轮数完全一样;"让循环长一点,风险自然会被时间冲淡"这个直觉是反的,时间是站在攻击者这边的,他只要把动作间隔拉得比冷却期长一点就行
直觉背后是这个事实:衰减给"低频攻击"买了几轮冷却期,但只要有冷却期,就有常数窗口;只要有常数窗口,攻击者就可以拉伸自己的时间表,反正攻击者不急
LoopHarness:循环级持久状态
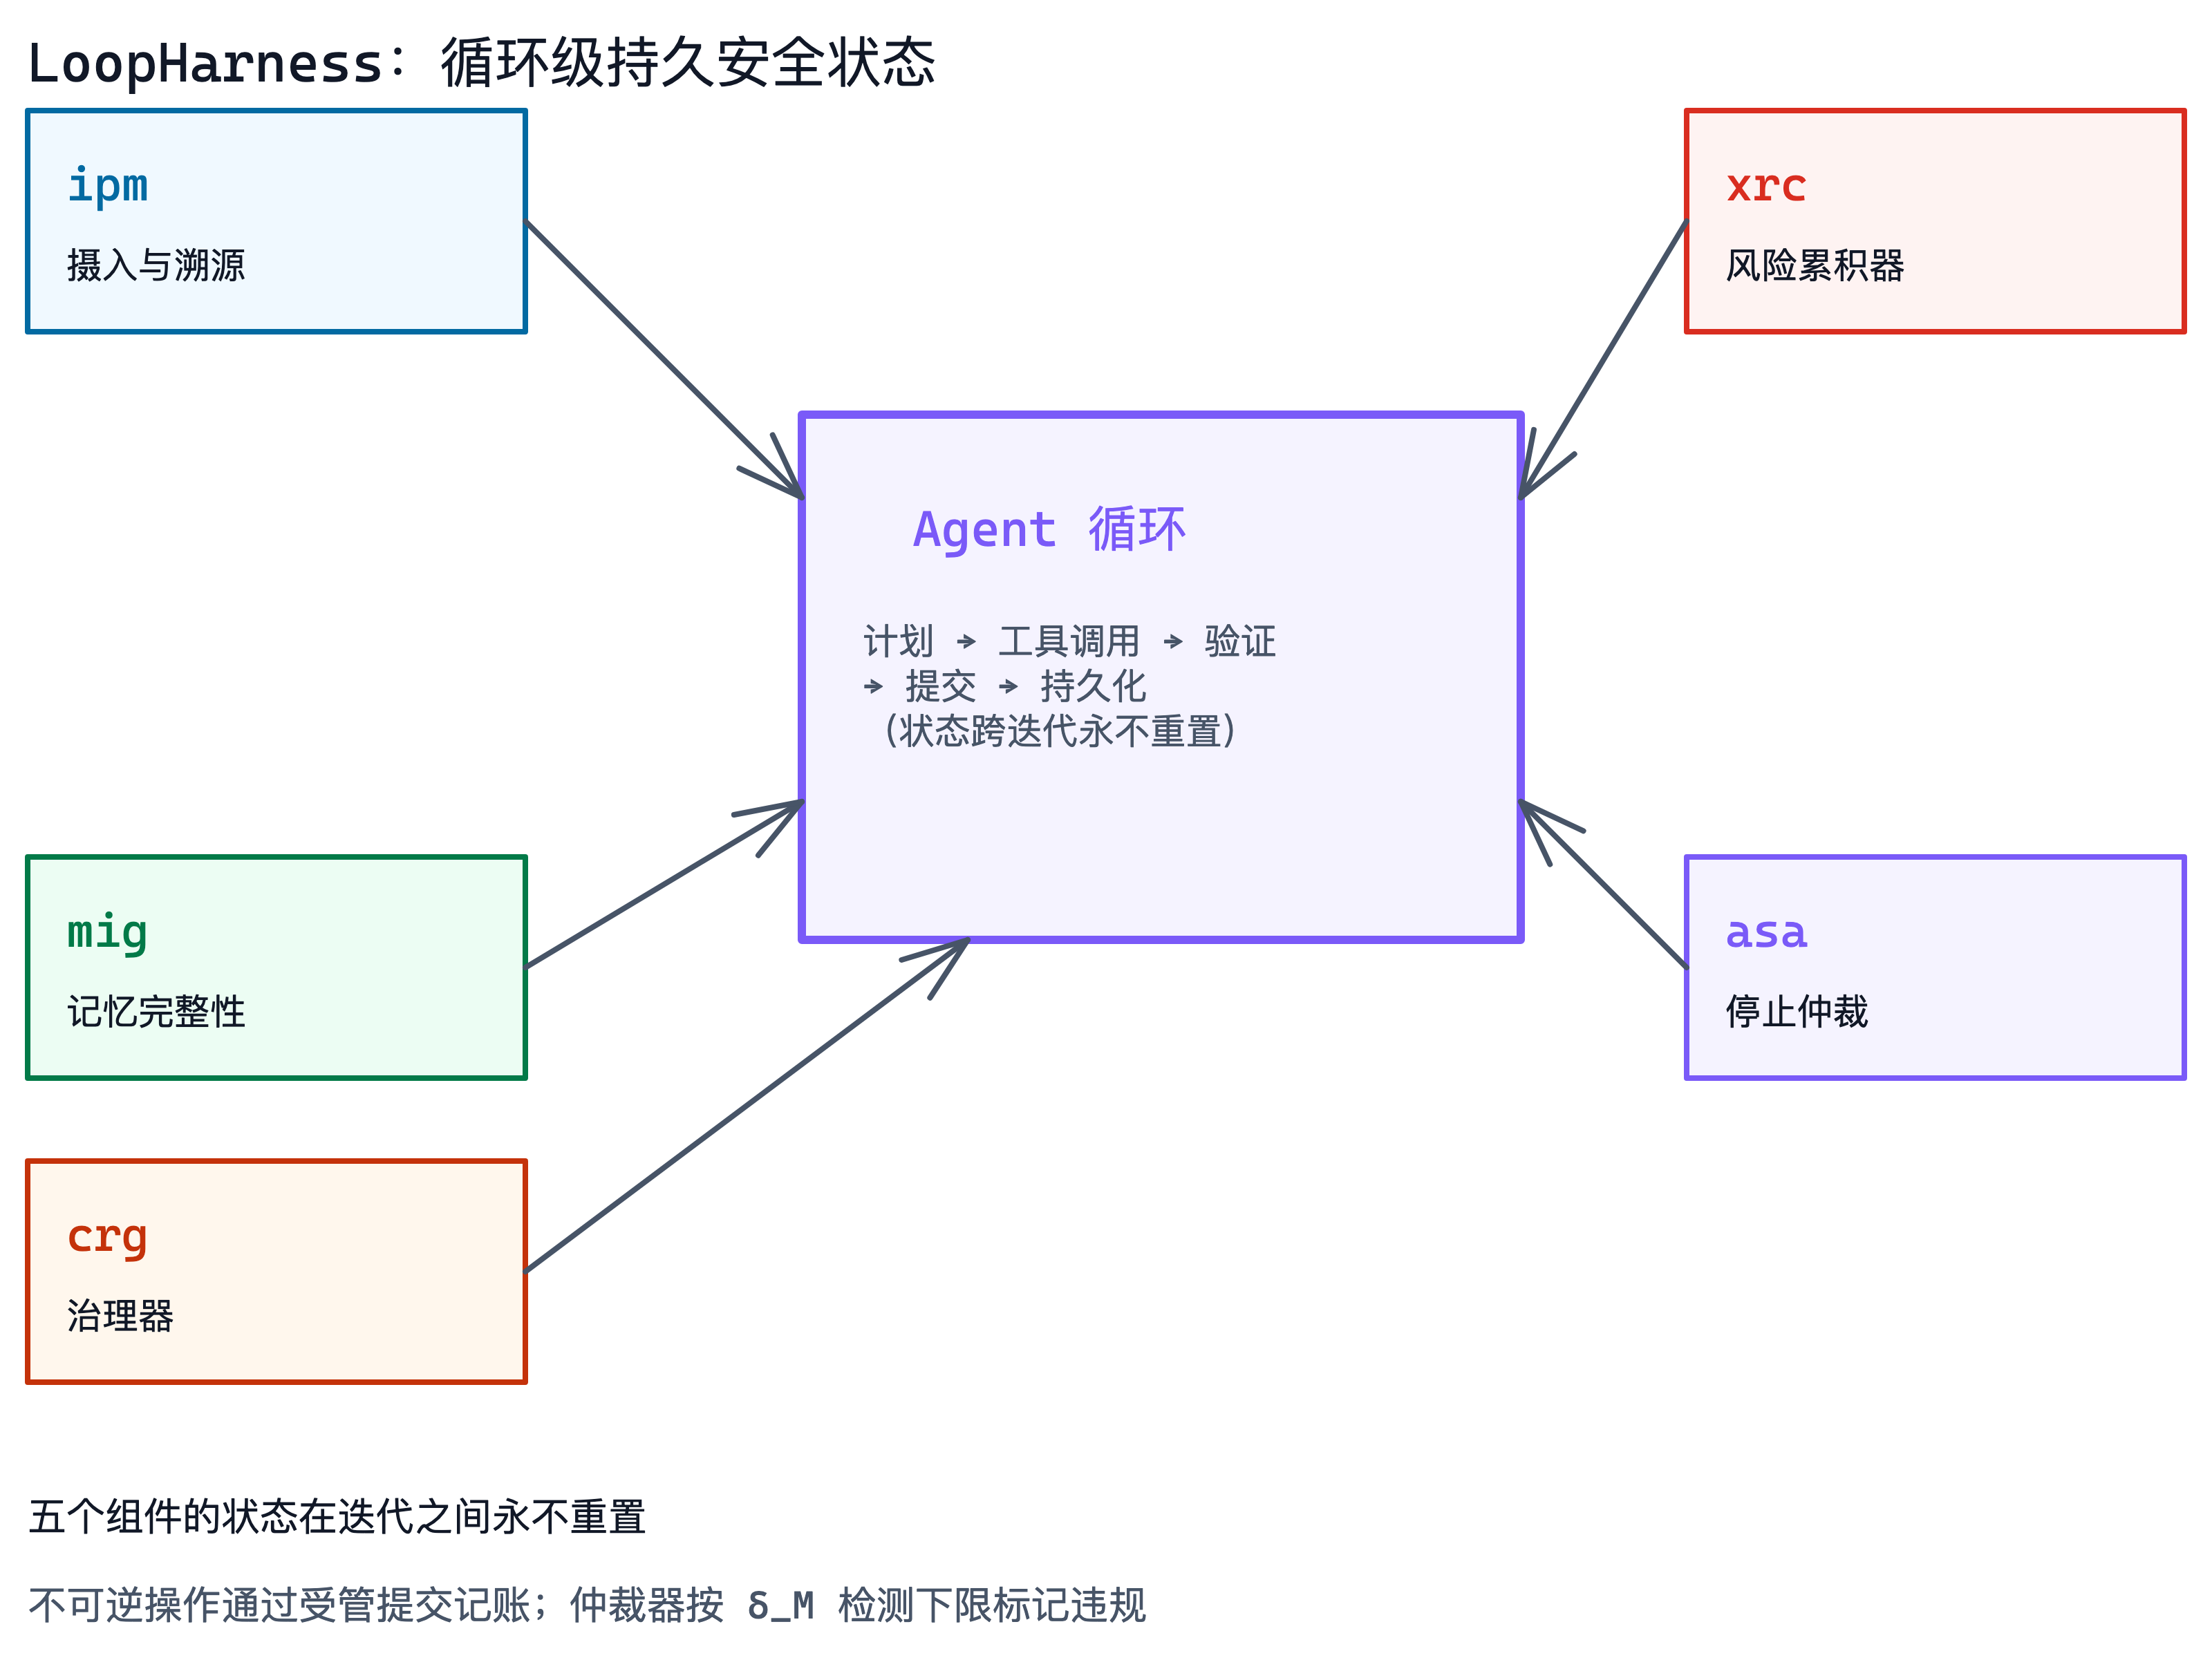
LoopHarness 不在单条轨迹里做防御,而是套在 L1-L4 内层 harness 外面,维护五个跨迭代永不复位的持久状态组件:
| 组件 | 作用 |
|---|---|
| ipm 摄入与溯源 | 默认拒绝的 6 条准入规则,控新工作项进入循环的入口 |
| xrc 跨迭代风险累积 | 核心创新:Ξ_i = max(r_i, γ_i · Ξ_{i-1}),结构性标志触发锁存 |
| mig 记忆完整性 | 追加式日志带链式 HMAC 标签,验证链不被回滚 |
| asa 停止仲裁 | 三层证据(确定性门 + 去相关检查器 + 窗口化发散量)按 δ_M 概率标记违规 |
| crg 治理器 | 硬预算 B + 能力阶梯,过线就升级操作员 |
三个关键设计决策:
- mediated commits:每个不可逆调用必须通过已核算的门,能力令牌限制一条轨迹最多
m₀次提交,ipm 每迭代最多接纳k个项目;代理接受的、无证据的提交不消耗预算,否则长序列的合法用户操作会被误判为失控 - 结构性标志锁存:只有规则可判定的契约违规(准入被绕、记忆完整性破坏、授权被破坏)才把
γ锁成 1,让Ξ永远不衰减;连续的高风险分数本身不触发锁存,否则正常的高影响工作(代码发布、回滚)会被永久卡死
Ξ_i = max(r_i, γ_i · Ξ_{i-1}) 的白话版本:每一轮的风险,取"本轮新发现的风险"和"上一轮风险打了折扣"里较大的那个;正常情况下风险会随时间衰减(γ 小于 1,老风险慢慢变淡),一旦触发结构性标志,γ 被锁死成 1,这个风险就永久保留,不会再被时间抹掉。为什么必须靠"结构性标志"而不是"风险分数高"来锁存?因为风险分数高可能只是正常的高影响操作(比如大版本发布),只有准入、完整性、授权这些可以机械判定的契约被破坏,才说明系统级出了问题
- 仲裁检测下限 δ_M:唯一进入概率分析的经验参数;被仲裁器标记的未授权提交,至少以
δ_M的概率被检测到,任意残留概率都按(1 − δ_M)^z尾界收敛
完整定理(论文定理 5):
U^{vis}_{1:N} ≤ B + m − 1      (几乎必然,无模型调用,无经验量)
𝔼[U^{inv}_{1:N}] ≤ m / δ_M   (随 δ_M 收敛)
𝔼[U_{1:N}] ≤ B + m − 1 + m / δ_M (与 N 无关的常数)确定性半边(B + m − 1)只需要治理器预算和 mediated commits 假设,即使验证器完全合谋也成立,因为它由"无模型规则"驱动,模型自己是攻击者时不会跟随
白话版本:无论任务跑多长,Agent 能造成"未授权的不可逆操作"总数都封顶在一个常数里,不会越滚越大;这个常数拆成两半,一半(B + m − 1)靠记账规则硬性封顶,不可逆操作要过门、要消耗能力令牌,总共就那么多额度,这部分不依赖任何 AI 判断,所以模型就算想作弊也突破不了;另一半(m/δ_M)靠仲裁器的检测能力,每一轮最多新增 m 个候选操作,每个操作至少有 δ_M 的概率被识破,漏网之鱼的期望数最多就是 m/δ_M;两条线合起来,就是"即使每步都有小概率漏过,总漏过次数也有上限"
XRC 的三种模式
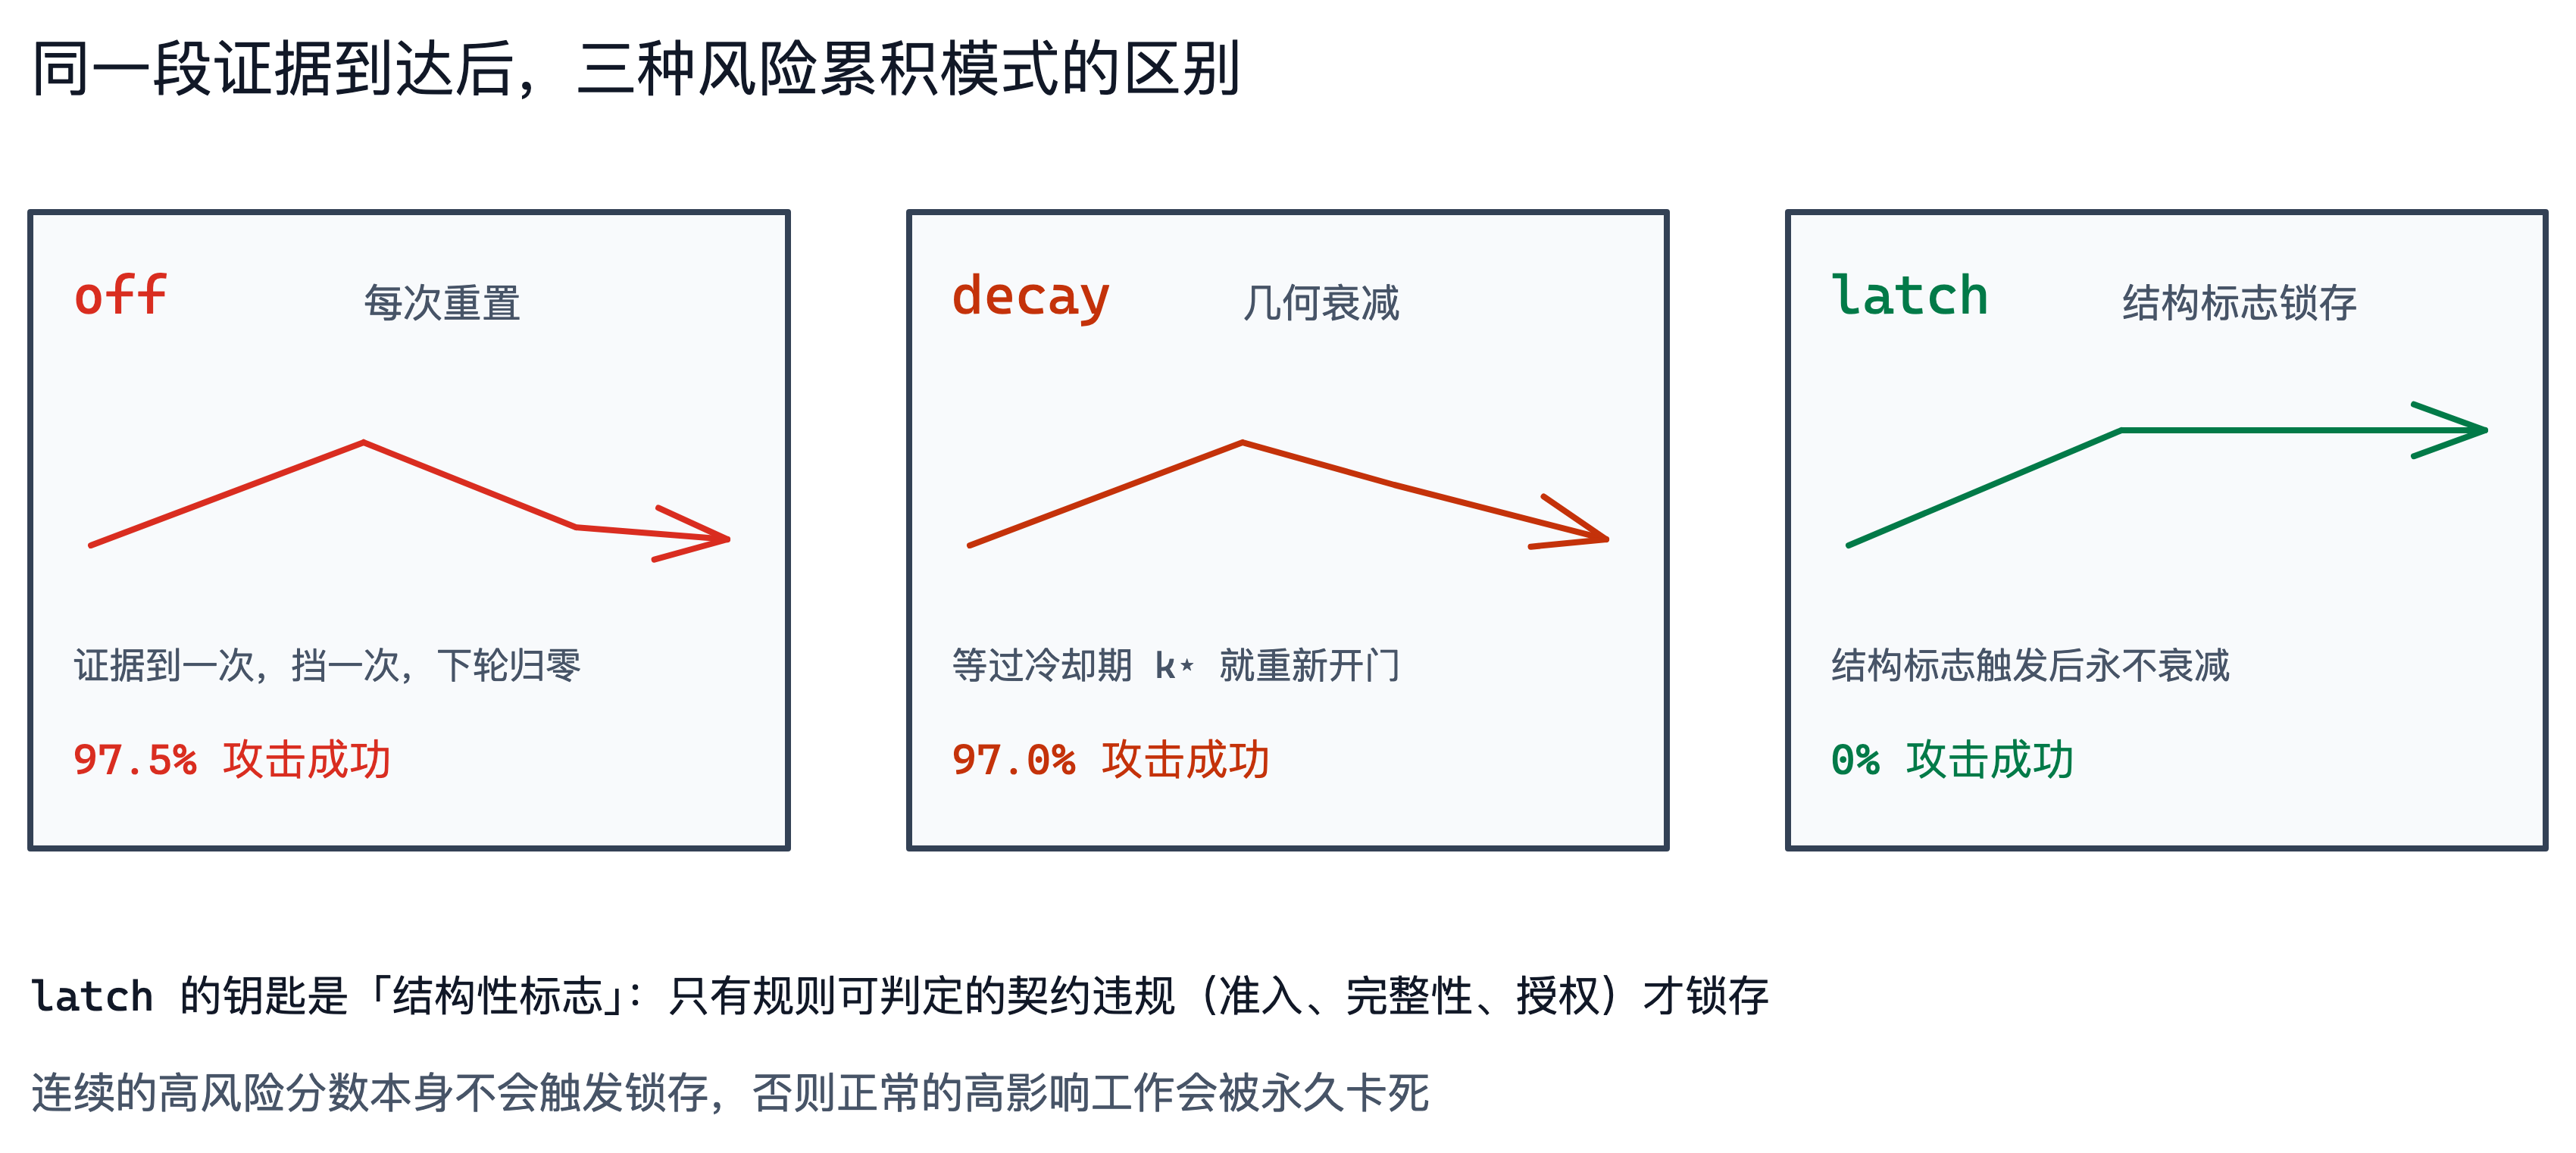
最直观的部分是 xrc 在三种配置下的对比;论文表 3 给了精确数字(ρ = 0.8, γ = 0.7, θ = 0.5,期望冷却期 k⋆ = 2):
| 配置 | 攻击间隔 d=1 | 攻击间隔 d=2 | 攻击间隔 d=4 |
|---|---|---|---|
| off(每次重置) | ASR 97.5% | ASR 95.5% | ASR 97.5% |
| decay(几何衰减) | ASR 0% | ASR 97.0% | ASR 97.5% |
| latch(结构标志锁存) | ASR 0% | ASR 0% | ASR 0% |
off 等于没有防御;decay 在 d=1 时挡住了,d=2 时 Ξ 已经从 0.560 衰到 0.392,门重新打开,攻击成功;latch 是唯一在所有间隔都保持 ASR 0% 的配置,这是论文说的"非衰减提供的是机会侧"的来源
锁存的钥匙是"结构性标志":只有规则可判定的契约违规才触发,高频高影响但合法的操作(提交、回滚)不锁存;论文用三层信号分流入 r_i、Ξ、锁存状态,正是为了避免"连续红但没有契约破坏"被永久封死
实验数据
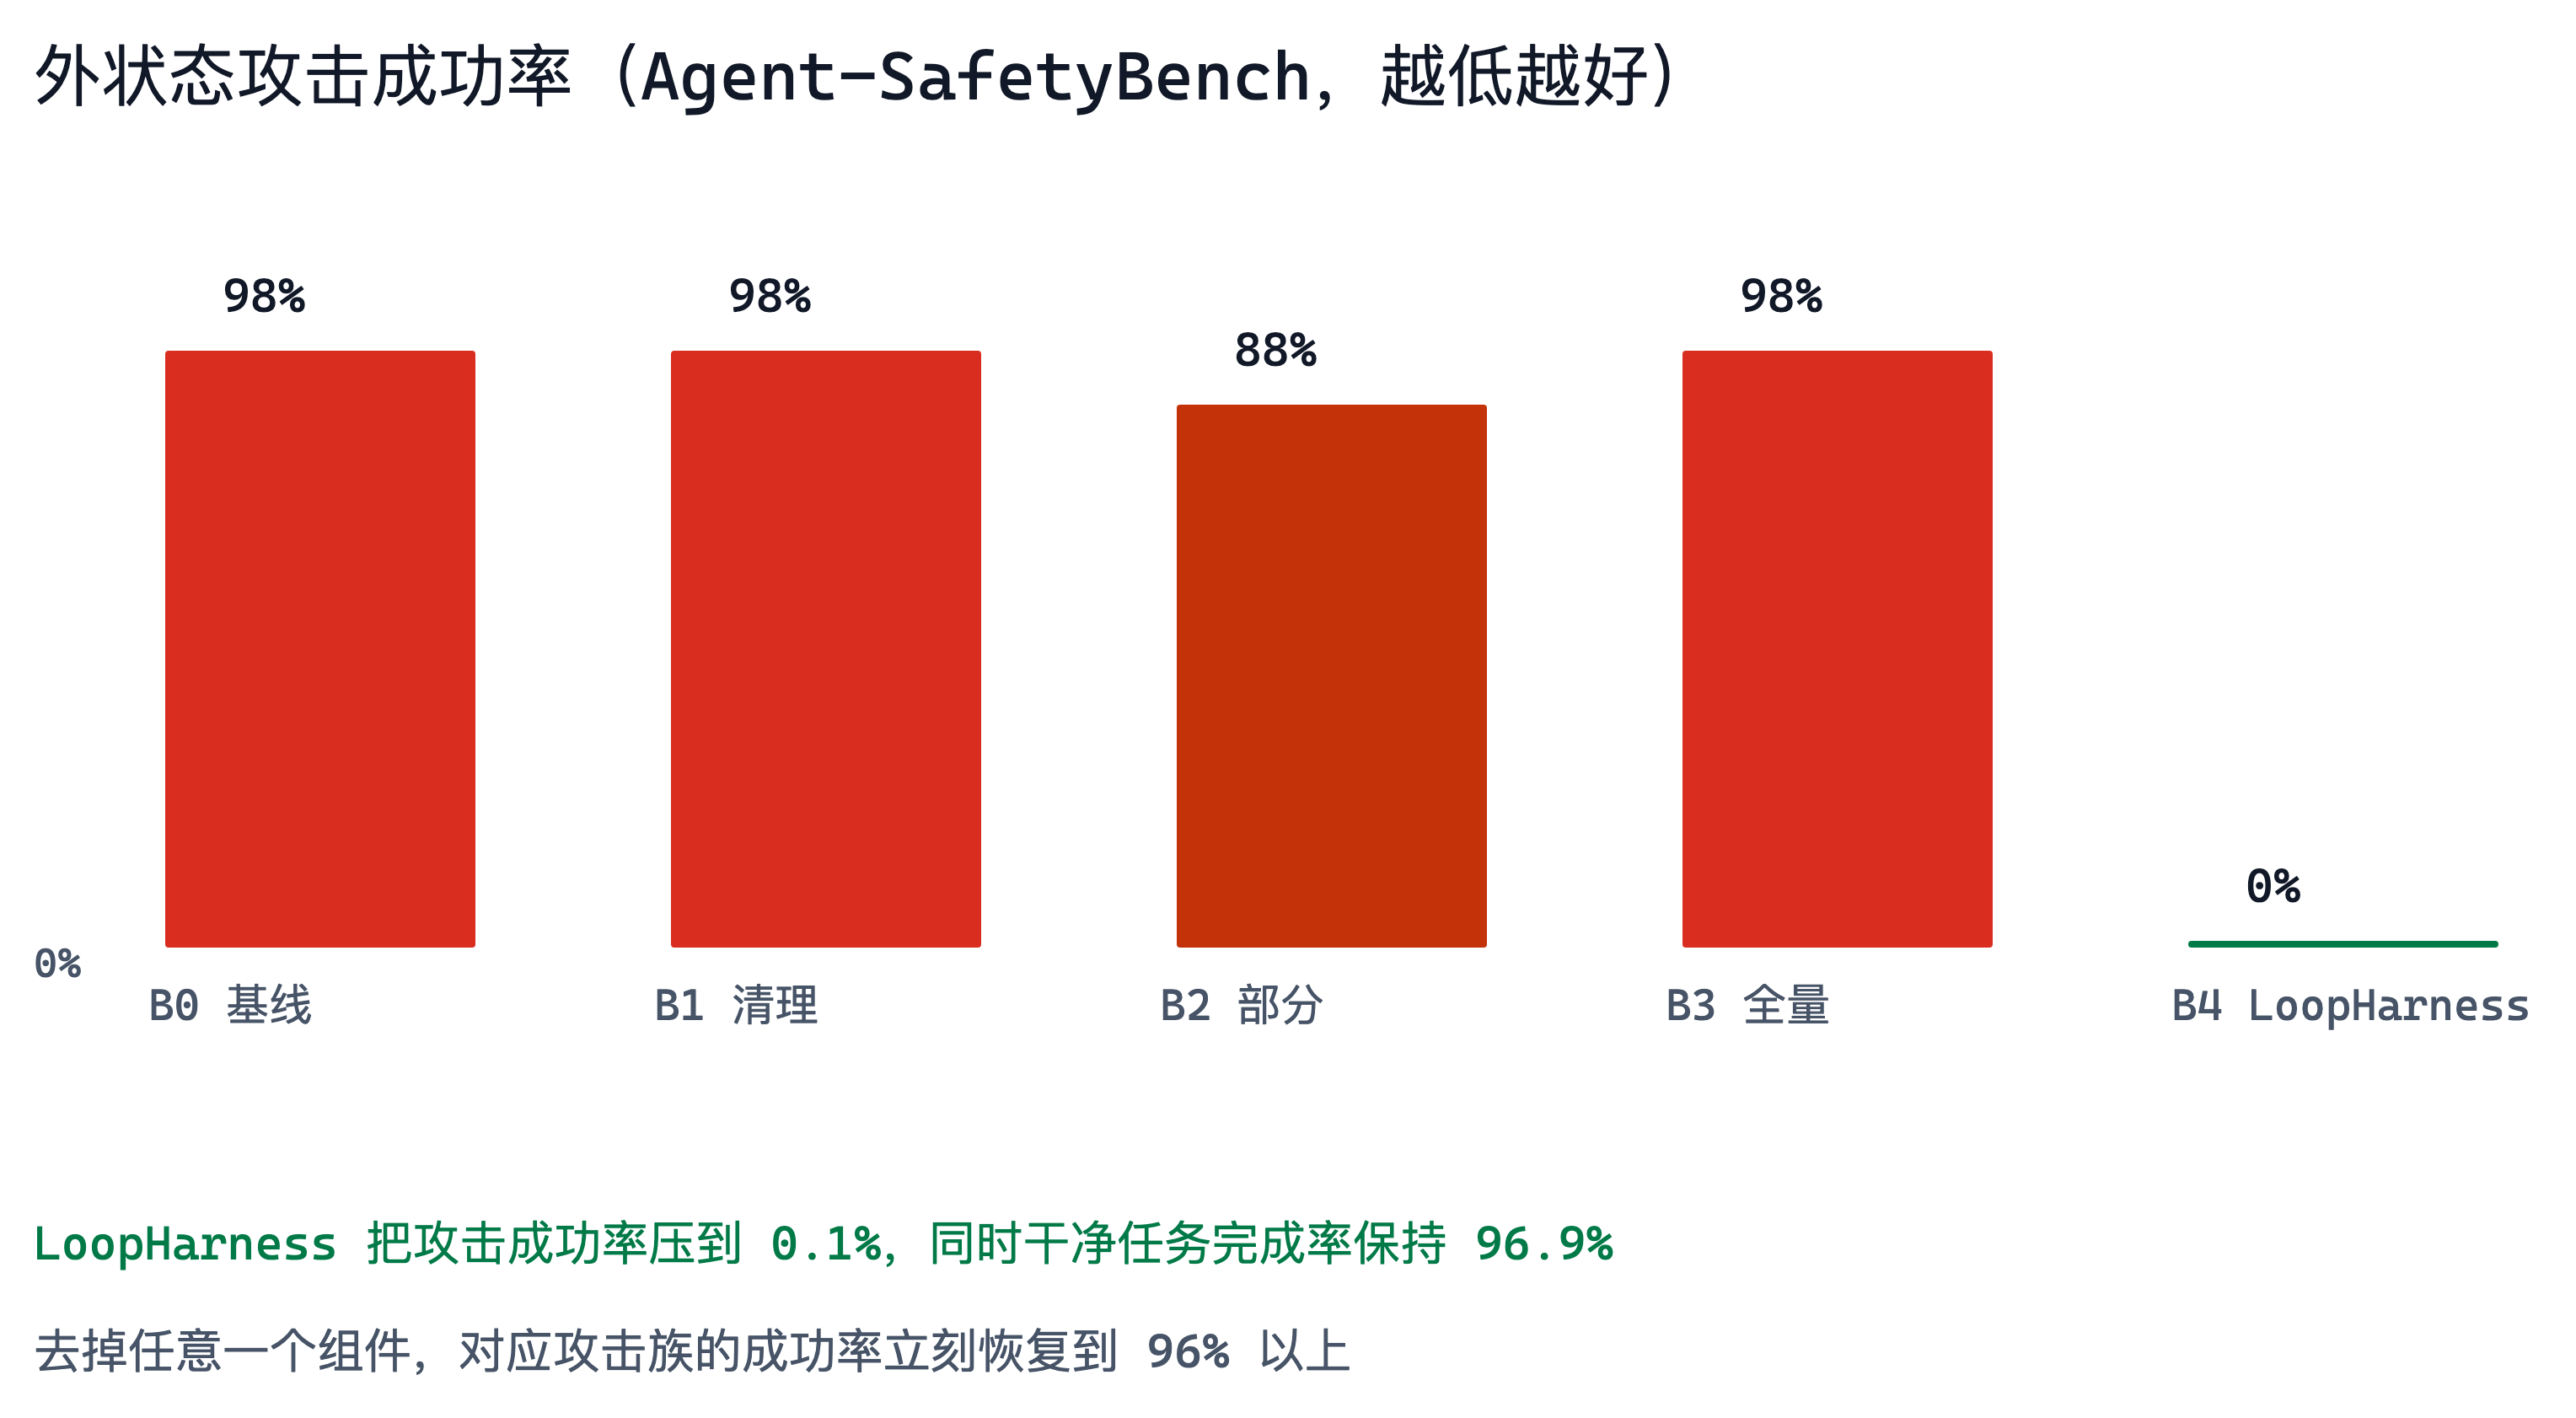
Agent-SafetyBench 200 情节 × 5 攻击族 × 5 任务长度(Track-A N=5/10/20,Track-B N=10):
- B4 完整 LoopHarness:整体 ASR 0.1%,CleanGC 96.9%
- B0-B3 各变体:ASR 在 88.4-97.6% 之间
- Track-A 复合攻击:B1 的 cASR 随 N 从 2.9%(N=5)涨到 6.2%(N=10/20);B4 恒为 0%
- 消融:去掉任一组件,对应攻击族恢复到 96-97.5%
- A-collude(强制检查器与 writer 共享模型族):ASR 仍 0.1%,CleanGC 降到 92.9%
A-collude 这个数字单独看:它验证了"模型本身是攻击者"这个最坏情况,完全合谋的验证器把干净任务完成率拉低 4 个百分点,但攻击成功率仍 0.1%;这是把 δ_M 设计为常数界最关键的设计收益
对 Agent 平台的工程启示
如果你的 Agent 平台支持长循环、无人值守、跨多轮的工具调用,无论代码 Agent、运维 Agent 还是客服 Agent,这篇论文给四条可落地的设计原则:
安全状态要跨迭代持久:把它和对话历史同等对待,存进独立的、带签名的持久层;一旦归零,跨迭代证据就再凑不齐
不可逆操作必须受管提交:删除、写入、部署、付款这些"一次下去回不来"的操作走单独通道,记账;能力令牌按任务发额度,用完就停
评估套件要包含跨迭代攻击:单步的"红队测试"和单元测试一样有局限,要测"每一步都过,组合起来失败"的情景,这正是 Track-B A11-A15 的价值
更大的上下文窗口不是解药:在 Prompt Cache 那一篇里我们讲了"上下文稳定",这篇从安全角度呼应,窗口再大,每条轨迹仍然有边界,跨迭代证据不会因为上下文能装下更多内容就自动出现在监控窗口里;安全状态必须和会话级状态解耦管理
模型能力可以靠更好的数据集、更大参数来提升,但只要 Agent 还会跨迭代地做工具调用,组合性安全失败就一直存在;LoopHarness 把"Agent 的安全"从单条轨迹的设计问题变成了循环级的工程问题
参考资料
- Chenhao Wu et al., Safety Does Not Compose: Non-Decaying Loop State for Autonomous LLM Agents, arXiv:2608.27141, 2026-08-27
- Agent-SafetyBench, Agent Safety Benchmark(论文使用的评估框架)
- OASIS, OASIS: Open Agent Safety In Sandbox(外状态攻击套件参考)
接口边界:本文基于 2026 年 8 月 27 日的 arXiv 预印本。LoopHarness 的作者提供了匿名化源代码、确定性回归套件、Track-A/Track-B 攻击轨道作为补充材料,但截至本文撰写时未公开 GitHub 仓库链接,确切实现细节与公开版本可能仍有差异。实验数字来自论文表 1-3,使用 deepseek-chat / gpt-4o-mini / gpt-4o / claude-sonnet-4-6 四个模型角色;不同模型与不同 δ_M 取值下的常数界需要复现确认。